
跨境客服助手(三):700 字切片与一条过期政策:知识入库流水线
上线前最容易被低估的一段,是知识入库。
问答出问题,大家第一反应是改提示词、换模型、调阈值;但很多错误的根在更早的地方:政策文件的 YAML 头被切进了第一条证据,模型把它当正文引用给客户;PDF 的出处标错了一页,点开引用看到的是目录;旧版政策没有禁用,检索时和新版一起召回。
这条流水线在 app/ingest.py 和 modules/doc_ingest/,做的是“把原件变成可检索、可核验出处的证据单元”。
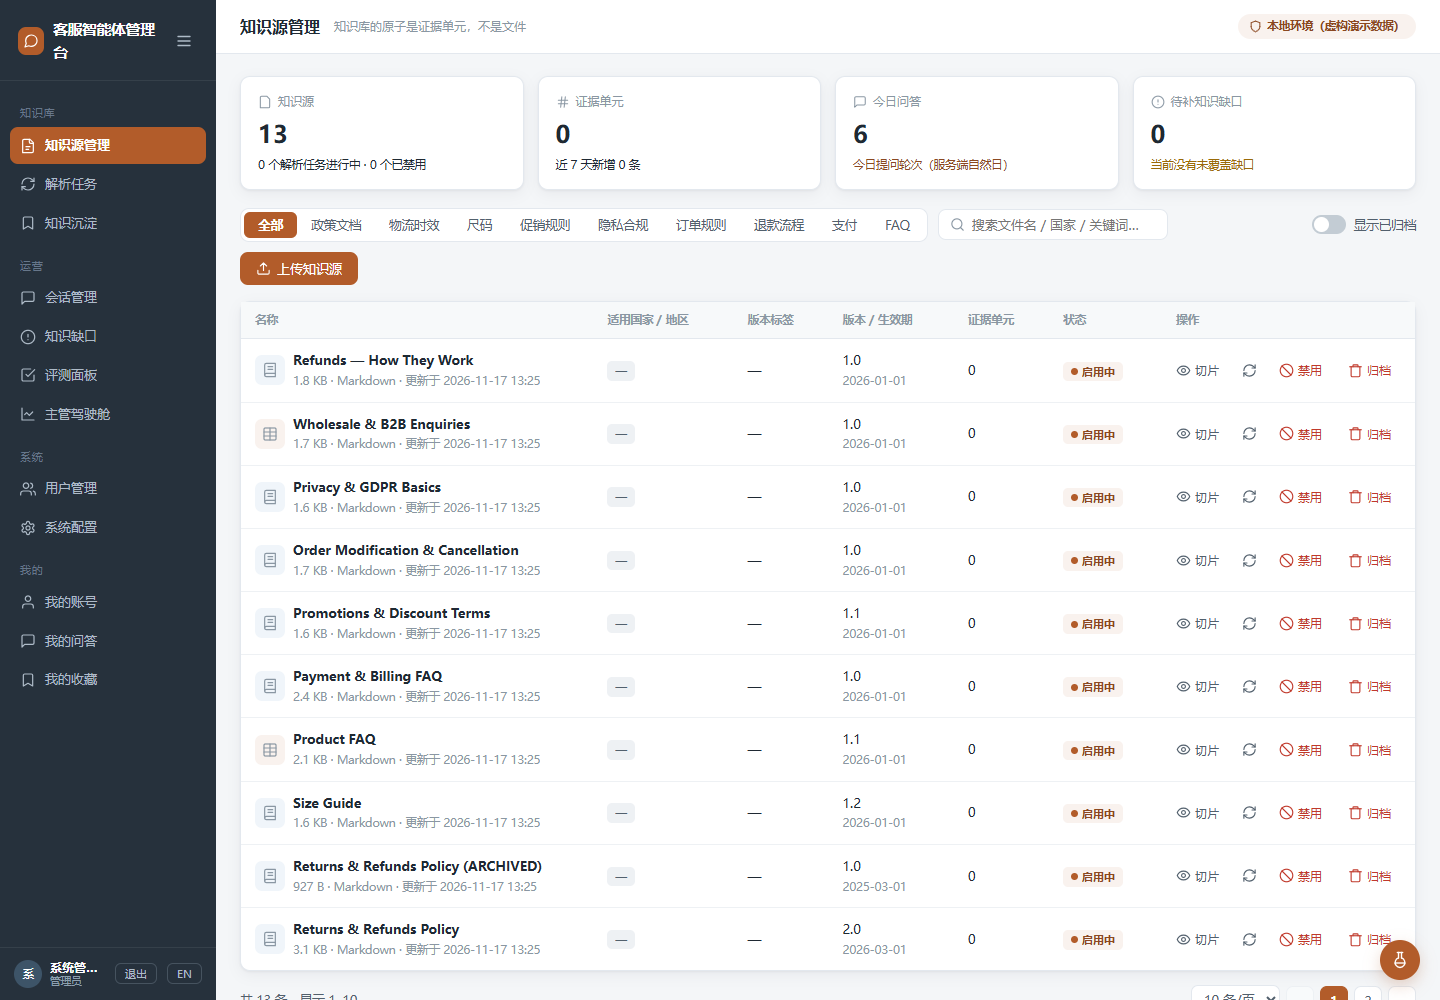
一、全链路:从上传到可检索
上传 / 批量导入
  → documents 建档(sha256 去重)
  → jobs 入队(或 --parse-now 同步解析)
  → 解析:PDF / DOCX / MD / TXT / Excel / CSV
  → 切片:700 字上限、120 字下限
  → 向量化:bge-m3,1024 维,批大小 16
→ chunks 落库(正文 + 元数据 + 向量 + BM25 预分词)管理后台上传和批量导入共用同一张后缀映射表,新增格式只改一处。建档时算 file_sha256,同一份文件重复上传直接返回已有文档,不会建出两份。
解析既可以同步做,也可以入队交给 worker。批量导入常用 --parse-now --no-enqueue:当前进程直接解析,避免同一批文档既同步跑又排队跑一遍。
二、front matter 不是正文
演示语料是 Markdown,每份文件顶部有 YAML:
---
doc_id: return-policy
title: Return Policy
version: "2.0"
effective_date: 2026-01-01
expires_on: 2027-01-01
applies_to: [US]
status: current
---这些字段决定检索时的国家过滤和有效期过滤。但它们不是给客户看的内容。如果直接整份文件送去切片,第一块证据里就会包含 doc_id: return-policy,模型完全可能把它当原文引用出来。
所以入库前先剥:
raw_text = path.read_text(encoding="utf-8", errors="replace")
_front, body = parse_front_matter(raw_text)
if body != raw_text:
    # 只把正文写进临时文件再解析,元数据走 documents.meta_json
parsed = parse_plaintext(body_path)元数据随后被整理成 camelCase,下放到每条切片:
inherited_meta = {
    key: doc_meta[key]
    for key in ("docId", "category", "version", "appliesTo",
                "expiresOn", "effectiveDate", "status", "language")
    if doc_meta.get(key) not in (None, "", [])
}下放的好处是检索后置过滤只查 chunks 一张表,不用回表 join documents;也不会因为文档元数据后来被改,出现“切片看不出来源”的情况。
三、切片的三个约束
切片器的参数是 max_chars=700、min_chars=120。三个约束来自一个目标:每块都能单独作为证据被引用。
约束一:出处随格式走
PDF 的出处是页码,所以不能用“估算页码”。解析时保留逐页文本,切片按页归属:
for page_no, page_text in section.page_texts:
    for paragraph in _paragraphs(page_text):
items.append((page_no, paragraph))一块跨了两页,就记 page_from 和 page_to。点开引用能落到正确的页,这是“可核验”的最低要求。
约束二:不做无依据的合并
段落优先切;单段超过预算时按句号硬切;短于 120 字的块并回前一块,但只限同一章节。
跨章节合并会让引用指错地方:客户点开“退货期限”的引用,看到的却是上一节“配送说明”。宁可多一块短证据,也不做这种合并。
约束三:标题随块走
每块正文以章节标题开头,检索命中时模型能看到“这是哪一节”。如果正文第一行已经是标题,就先去掉再统一补,避免每块重复两遍。
表格类资料例外:FAQ Excel 和数据表按“一行一条记录”切,正文拼成“列名:值”,首列作为章节分组。单文件超过 5000 行直接拒绝,要求拆文件——一行一片的情况下,超大表会把检索噪声放大。
四、过期政策:入库,但禁用
那条 60 天的旧退货政策没有被删掉,而是以 status: archived 入库。
这是刻意的:留档才能解释“为什么以前这么答”,也方便审计。但它不能参与检索,所以入库时给每条切片打上 disabled=true:
blocked_reason = inactive_reason(doc_meta)   # status=archived / expiresOn 已过
...
chunk_meta["disabledReason"] = blocked_reasonchunks.disabled 是检索的硬过滤条件;即使有人绕过它,第二篇讲的后置过滤还会按 status 和 expiresOn 再挡一次。两层防线看起来重复,但一层是存储约束,一层是业务语义,改一处不影响另一处。
评测集里有 3 条“新旧冲突”用例带 noArchived: true,专门断言回答不能引用归档切片。没有这条断言,禁用逻辑坏了也不会被发现。
五、幂等:重复解析不翻倍
同一份文档改了元数据、换了 embedding 服务,都需要重新解析。如果每次追加切片,知识库会迅速变成一团重复。
所以落库事务是“先删后写”:
cur.execute("delete from chunks where document_id = %s", (doc_id,))
for draft, vector in zip(drafts, vectors, strict=True):
cur.execute("insert into chunks (...) values (...)")同一文档重复解析多少次,切片数都只跟当前版本有关。文档级的 file_sha256 则挡住“同一份文件建两次档”。
六、证据 ID:一眼能看出出处
切片落库时生成 evidence_id,格式是“分类前缀 + 两位文档号 + 三位序号”,例如 RP01003。
前缀按资料分类走:退货政策 RP、配送 SP、尺码 SZ、支付 PM、隐私 PR、促销 PV、订单 OP、FAQ FQ。后两段保证全局唯一且可排序。
这个 ID 会出现在引用卡片、后台切片预览和导出文件里。它不承载业务含义,但能让人快速判断“这条是政策还是 FAQ”,排查串库问题时很有用。
七、这条流水线的边界
- 不做 OCR。整份 PDF 抽出的有效文本少于
max(20, 页数 × 5)个字符时判为疑似扫描件,直接提示需要 OCR,而不是硬塞空切片; - 切片质量受原件结构影响。多栏排版、表格嵌图的 PDF,解析出来仍然可能是乱的;
- 碎片会被过滤。切片后短于 20 个字符的残片直接丢弃(
MIN_DRAFT_CHARS=20),页眉、目录这类碎片不会成为证据; - 语言以英文语料为主。BM25 用 jieba 预分词,英文能切,但中文语料的检索效果没有专门评测。
入库决定了检索的上限。下一篇换一条完全不同的路:订单和物流不查知识库,查工具;而工具会超时,超时之后说什么,才是真正需要设计的地方。