
BiliTube:翻完 4,739 个视频,留下 1,774 个
打开 B 站搜「大模型」,你会看到同一个话题的几十个版本:有 40 分钟讲清注意力机制的,有 3 分钟念 PPT 的,有把别人的课程剪成合集的,也有讲得极好但播放量只有几千的。播放量排在前面的,未必是最值得花时间的。
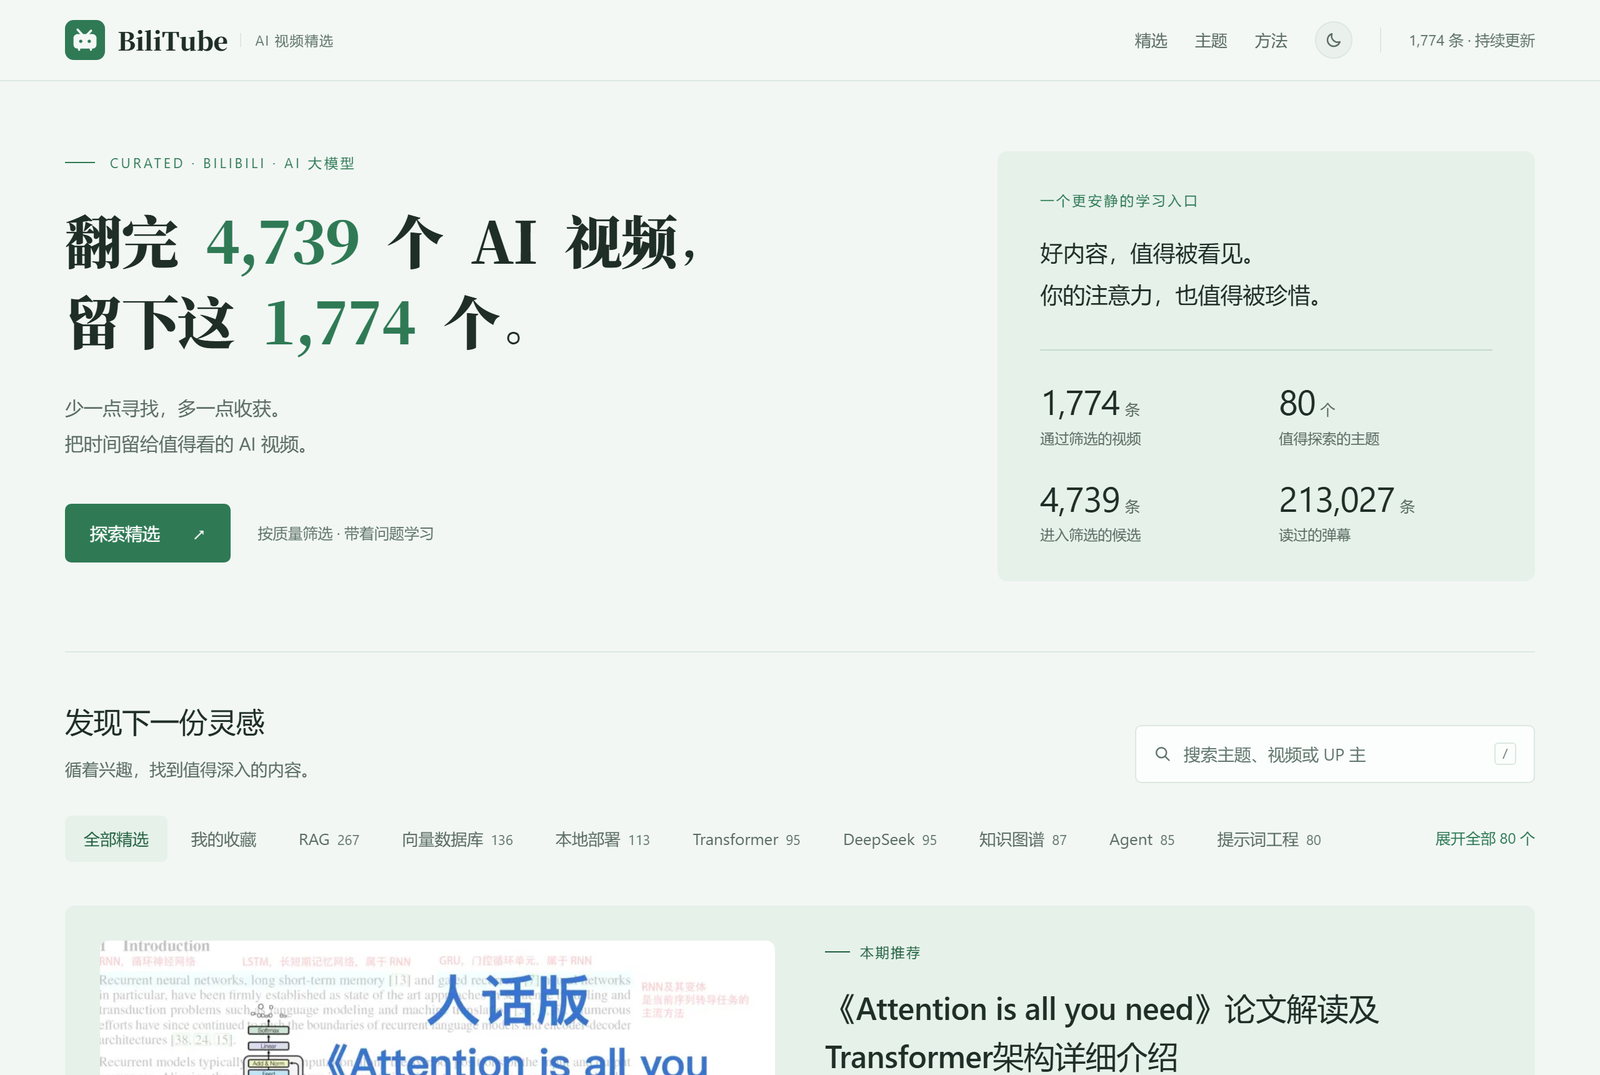
BiliTube 想解决的就是这件事:不推荐最火的,推荐最值得看的。它每周翻一遍 AI 相关视频,先按规则挡掉噪音,再在同分区、同时长里比相对表现,最后让模型读完简介和弹幕写一张卡片,导出成一个能按主题、难度、时效筛选的静态站。
项目地址:zhaoxuejie/moqian-bilitube,MIT。线上站:www.51bilitube.com。
你在这里
这是系列概览。先讲清楚这条流水线长什么样、九个篇目各讲什么,不展开代码。想直接看某一块,可以跳到文末的目录。
一、它到底在做什么
2026-11-10 那次周更的数据是这样的:
| 指标 | 数值 |
|---|---|
| 进入筛选的候选 | 4,739 条 |
| 最终精选 | 1,774 条 |
| 覆盖主题 | 80 个 |
| 读过的弹幕样本 | 213,027 条 |
| 导出数据 | 约 1.7 MB JSON |
| 构建页面 | 1,776 页 |
整条链路没有数据库服务、没有后端进程:
关键词矩阵 → 搜索采集 → 详情补齐 → 硬过滤 → 分位打分
           → 弹幕采集 → 模型卡片 → 导出 JSON → 静态站
它不是一个「视频推荐系统」。没有用户画像,没有点击反馈,也不做个性化排序。它更像一本每周更新的精选刊:编辑口径写在配方里,流水线负责把口径执行到底,站点负责让人按主题翻。
这也决定了它的技术形态:离线跑、单机跑、结果落一个 SQLite 文件,最后只把一份 JSON 交给静态站。没有请求时的推理,没有在线数据库,也没有「服务挂了」这种状态。
二、三个反直觉的决定
决定一:不按播放量排,按同组内的相对位置排
最早的想法很自然:收藏率高、投币率高、播放量高,就是好视频。实际数据很快打了脸。
B 站「收藏数」和「播放数」的口径并不一致,收藏率可以超过 100%。实测样本里有一条播放 1,141,309、收藏 1,286,533,收藏率 112.7%。拿这种数字做绝对阈值,等于在一个量纲都不统一的指标上画线。
更麻烦的是分区差异。「财经商业」的收藏率和「野生技能协会」完全不是一个基线,10 分钟的视频和 90 分钟的视频也不可比。固定阈值会系统性地高估某一类内容。
最后的做法是分位归一:把视频按「分区 × 时长档」分组,组内按每个互动指标排百分位,再加权成机器分;组内样本不足 30 条时退化为全站分位,并打上 low_sample 标记。分数只回答「在同类里排第几」,不回答「绝对值有多高」。
决定二:引擎开源,配方不开源
「怎么跑」在代码里,「按什么标准跑」在配方里。一个配方就是一个目录,五个文件:关键词、过滤规则、打分权重与分桶、生成卡片的 prompt、元信息。
仓库里只有 presets/example/ 这个最小示例。真实的 20 个关键词、词表、权重和提示词不公开。这不是故弄玄虚:配方决定了榜单长什么样,公开配方等于公开一套可以被反向优化的标准。而引擎本身——限速、断点、分位、导出——是可以复用的。
这个拆分也顺手解决了另一个问题:改权重不用改 Python,不用跑类型检查,换一个领域只需要换一个目录。
决定三:不做后端,连数据库都不上服务器
站点是 Next.js 的 output: "export" 纯静态产物。首页、1,774 个详情页、隐私页、404,全部在构建时生成。部署在 Cloudflare Workers 静态资源上,没有运行时查询。
代价是放弃了个性化推荐和服务端搜索;收益是零运维、零账号、零用户数据。对一个「每周更新一次、所有人看到同一份榜单」的产品来说,这笔交易很划算。
三、九个篇目
| 篇目 | 讲什么 | 你会看到 |
|---|---|---|
| 概览(本篇) | 全景与三个决定 | 数据流、边界、读法 |
| 一 | 采集被 412 拦住后,怎么恢复 | 风控识别、重试分类、主动熔断 |
| 二 | 用 SQLite 断点续采,重跑不重复 | 表结构、幂等 upsert、采集状态 |
| 三 | 规则先筛、分位再排,把候选筛成精选 | 过滤规则、百分位、低样本退化 |
| 四 | 让模型读弹幕,给视频写推荐卡片 | 证据拼装、JSON 稳定输出、内容分回写 |
| 五 | 关键词、权重、提示词怎么拆成外置配方 | preset 目录、校验、权重与 prompt 外置 |
| 六 | 把榜单做成纯静态站,搜索筛选不靠后端 | 静态生成、浏览器端筛选、封面直连 |
| 七 | 每周数据更新与 tag 发版,怎么避免误上线 | tag 发版、快进校验、周更脚本 |
| 八 | 这套系统能做什么,不能做什么 | 已知偏差、没做的事、如果重来 |
如果你只想挑一篇看:
- 想复刻一条采集流水线:先看第一、二篇,再看第三篇的分位。
- 想给内容做自动评估:直接看第四、五篇,那里有证据拼装和配方拆分。
- 想把结果做成静态站:第六、七篇。
- 想判断这套东西值不值得学:看第八篇,我把不好听的部分都放在那里。
四、这个系列不写什么
有三条边界,先说在前面。
不公开真实配方。 文章里会出现配方的结构、校验逻辑和示例,但不会出现线上关键词表、词频权重和完整 prompt。这不是藏私,是这类内容策展产品的基本边界:标准本身就是产品的一部分。
不评价具体 UP 主。 文中出现的视频只作为数据样本,用中性描述,不做好坏判断。榜单是统计结果,不是对人的评价。
不虚构开发过程。 项目的 CHANGELOG 从 2026-11-05 记到 11-10,文章里提到的「踩坑」都对应真实的提交、ADR 或故障记录;没有发生的争论不补写,没解决的问题也不装作解决了。
五、先记住这一句
这条流水线真正的设计重心,不在「让模型判断视频好不好」,而在让判断可解释、可重跑、可替换。
规则错了,改词表;权重不对,改配方;模型换了,重跑卡片;数据要更新,一条命令增量补齐。每个环节都能单独验证,不需要把整条链路推倒重来。
下一篇从最脏的一段开始:怎么在不触发风控的前提下,把 4,739 条候选搬回家。