
财报透视:每个数字都能点回原文的年报解析器
老周每年四月都会消失两周。
不是去旅游,是去读年报。他是个写后端的工程师,下班以后给自己定了个规矩:持有的、关注的公司,年报必须自己从头翻一遍。一份年报两三百页,三张报表藏在一百多页之后,附注又在更后面。他的工作流是:PDF 开两个窗口,一个看报表一个翻附注,Excel 开一个,手抄数字,自己算增速。
去年他试过把 PDF 直接丢给 AI 聊天工具,问「这家公司经营现金流和净利润差多少」。回答很流畅,数字也像模像样。他接着问了一句:「这个数在第几页?」
然后对话就开始变得有点尴尬了。
老周是虚构的,但他的工作流不是:很多认真读年报的人就是这么干的。本系列用到的真实公司(科大讯飞、海康威视、立讯精密、金山办公、中芯国际)只是仓库评测集里的解析样本,文中所有数字都只用来说明解析效果,不构成任何投资建议,也不评价任何公司的经营好坏。
这个项目做什么,不做什么
上传一份或几份 A 股年报 PDF,几秒钟后得到一份财务视图:
- 三表结构化:合并资产负债表、利润表、现金流量表,保留原文的本期、上期两列
- 20 项核心指标:扣非净利润、经营现金流、ROE、毛利率、资产负债率、应收与存货周转等
- 11 张多年趋势图:同一公司多年年报对齐成时间序列
- 异常项:只陈列数字之间的矛盾,比如应收增速远高于营收增速、经营现金流低于净利润
- 原文溯源:每个数字旁边一个「溯源」按钮,点开是页码和原文片段
明确不做的事同样写进了需求文档的第一页:不预测涨跌、不估值、不荐股、不说「值得买」。异常项的措辞也有约束,只能写「应收账款增速 X%,营收增速 Y%,差额 Z 个百分点」这样的事实,不能写「回款质量堪忧」这样的判断。为了守住这条线,代码里有一张禁用词表:导出文件生成时过一遍,命中就不让导出;页面上的规则文案在测试里过同一张表。
一句话:它负责把原文里的数字整理干净、摆到你面前,判断留给你自己。
为什么不把 PDF 直接交给大模型
老周那个尴尬时刻,问题不在模型「不够聪明」,而在两件事:
第一,数字不能有一个字的误差。一份年报里的「1,655,284,064.88」,抄成「1,655,284,046.88」,读着毫无违和感,算出来的增速就错了。大模型生成文本是按概率挑字的,十位数的金额它大多数时候能抄对,但「大多数时候」放在财务数据上是不够的。
第二,你得能核对。就算模型抄对了,你也得翻回原文确认一遍,否则不敢用。如果每个数字都要人工翻页核对,自动化就省不了多少时间。
所以需求文档里的第七条决策是这么写的:
计算全部由脚本完成,LLM 只做科目对齐与文案措辞;数字不得由 LLM 生成或改写。
数字从 PDF 的文本层里原样抠出来,用 Decimal 做换算和计算;每个数字在抠出来的那一刻,就把页码和那一行的原文片段一起记下来。整个系统围绕的就是这件事:可核对。
顺便自嘲一句:这个仓库最初的名字叫 finance-agent,后来改成了 moqian-fin-lens。改名改得很对,因为到现在为止,它调用大模型的次数是 0。运行日志里有个字段叫 llm_calls,代码里写死的就是 0。原本留给大模型的那件事(规则对不上的科目让模型给候选),是初代版本还没做的事之一,第 7 篇会讲。
它长什么样
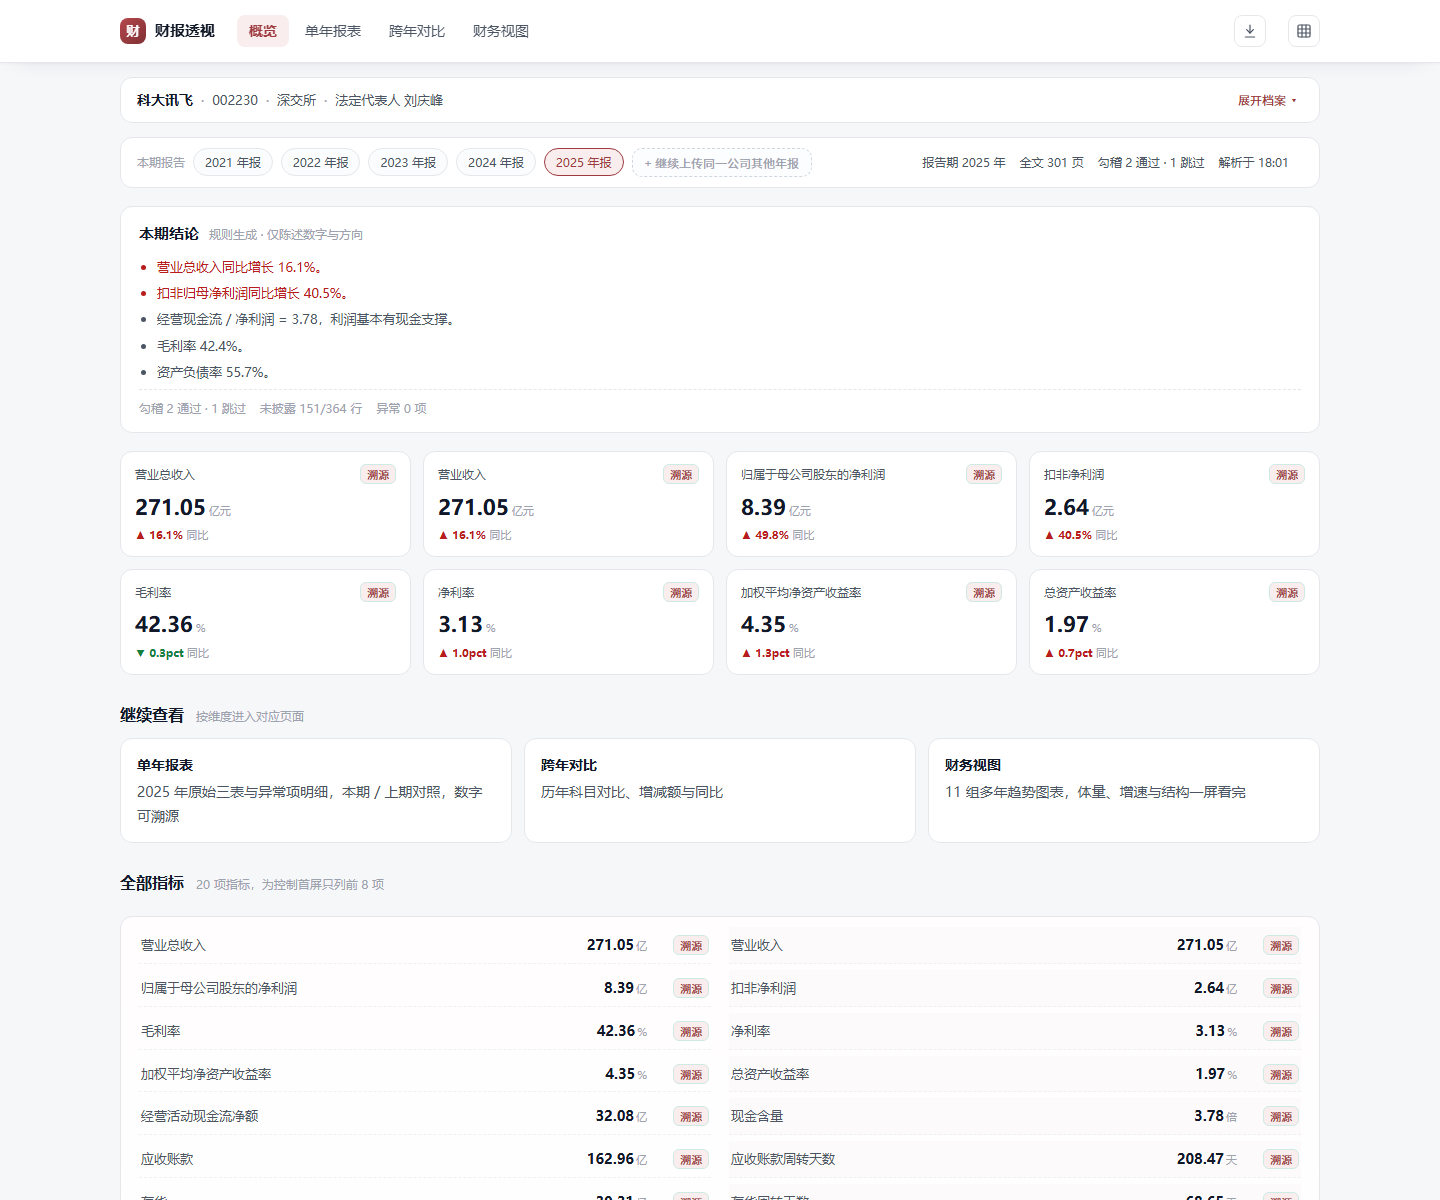
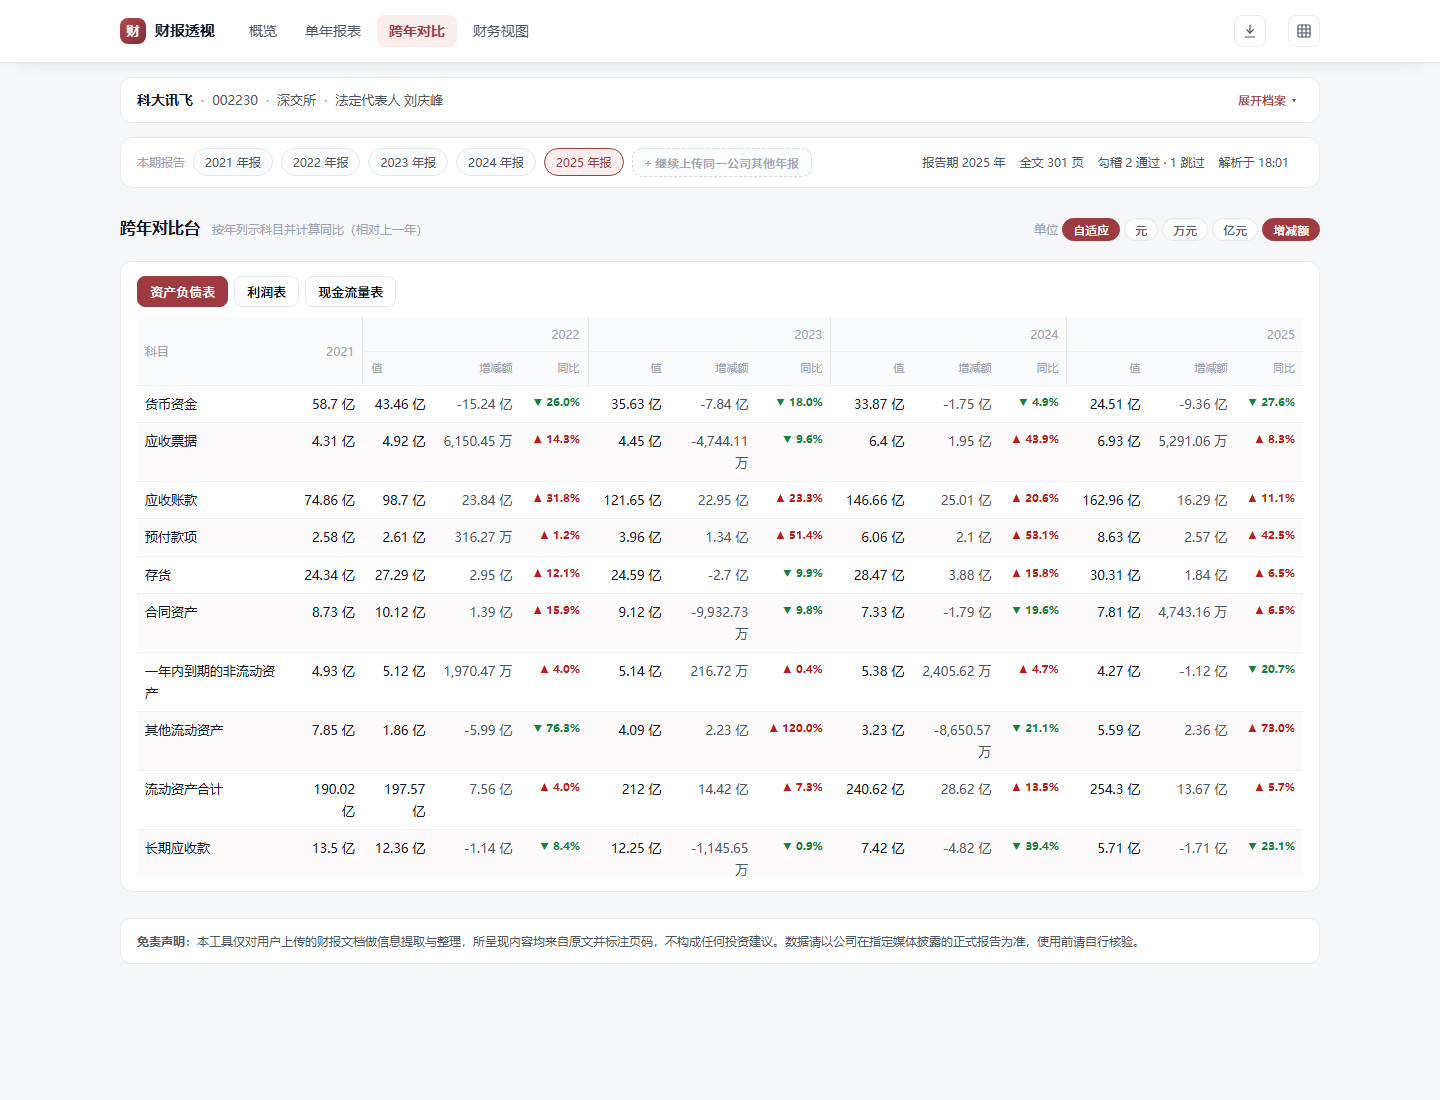
概览页上,「本期结论」是规则生成的,只陈述数字和方向;下面的指标卡每张都有「溯源」角标。这几张截图来自仓库 README 里的演示会话:科大讯飞 2021~2025 五年的年报依次上传,自动对齐成五个期次。
| 单年报表:原始三表 + 每行页码 | 跨年对比:增减额与同比 |
|---|---|
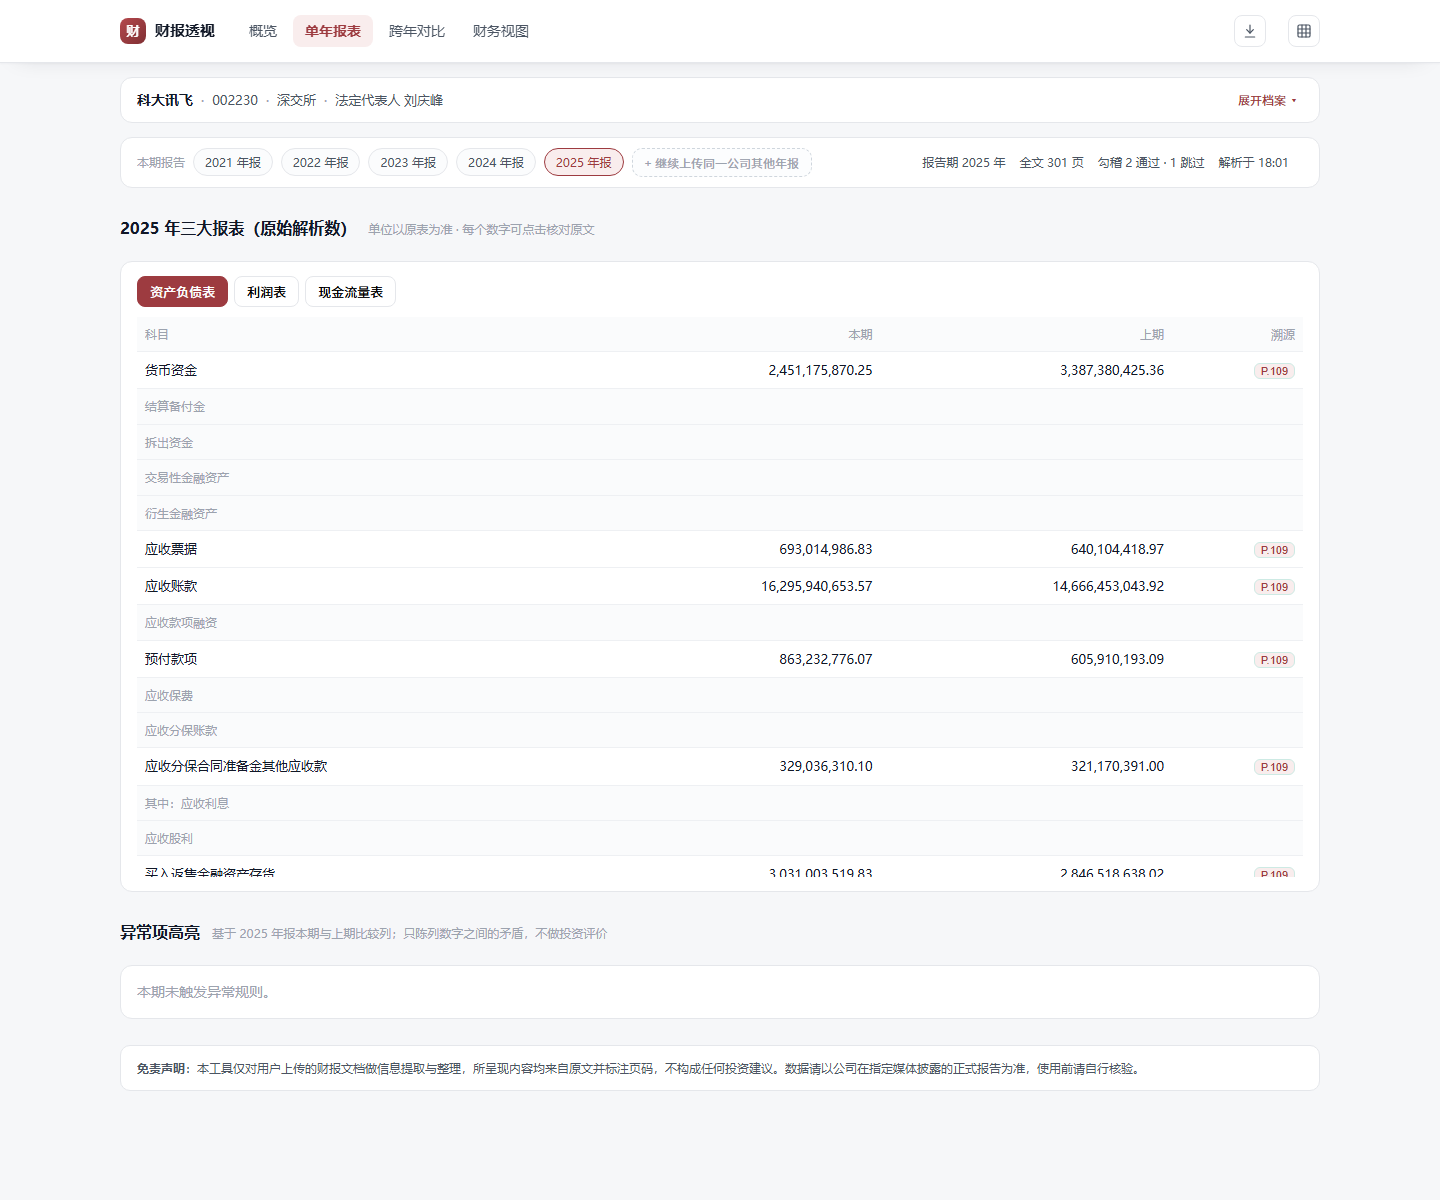 |  |
单年报表右边那一列 P.109,就是这一行数字所在的 PDF 页码。点一下,浮层里是这一行的原文片段,再往下是那一页的整页原文。
系统全景
一份年报在系统里走三段路:
解析:PDF 变成带页码的行。先从三百页里找到三张合并报表各自在哪几页,再把表格还原成「科目名 + 本期 + 上期」的行,跨页断开的行要接上,被表头吞掉的首行要补回来。最后把「(1,234.56)」「—」「1.2亿元」这些写法统一成标准数值。空值不是 0,这一条后面会反复出现。
计算:行变成指标和矛盾。原文科目名映射到 134 项标准科目,算 20 项指标和同比,做三条勾稽校验(资产 = 负债 + 权益等),再跑 8 条异常规则。
呈现:四页看板、溯源浮层、Markdown 和 Excel 导出。所有图表数据都由后端算好,前端只负责画。
图里的四个红色出口是我最想让你注意的部分:认不出的文件拒收,找不到三张表就整份失败、不出半成品,缺了的科目写「原文未披露」、不补 0,勾稽不平就在页面顶部挂黄条、列出差额。一个只会输出数字、从不承认「我没找到」的解析器,比没有解析器更危险,因为你会相信它。
右下角那个虚线框是 LLM 科目兜底,还没做。
技术选型:单人维护优先
| 要解决的事 | 我的选择 | 没选的 | 为什么 |
|---|---|---|---|
| PDF 文本层 | pypdfium2 | PyMuPDF | PyMuPDF 是 AGPL,闭源分发要买商业授权;pypdfium2 是宽松许可证 |
| 表格抽取 | pdfplumber | MinerU 类版面模型 | 年报是文本型 PDF,表格线和坐标够用;版面模型要拖一堆模型权重,部署重 |
| 数值计算 | Decimal | float | 「1.2345 亿元」换算成元必须精确相等,不能多出个 0.0000001 |
| 存储 | SQLite(WAL) | PostgreSQL | 单机、单写;结构化结果和溯源片段同一个文件,备份就是拷文件 |
| 任务执行 | 进程内线程池,5 并发 | Celery + Redis | 少两个要运维的组件;v1.0 的并发量用不上队列服务 |
| 前端 | 服务端渲染 + 原生 JS + 本地 ECharts | React / Vue | 一套 Python 栈,没有 Node 构建链;ECharts 打包在仓库里,不依赖 CDN |
其中解析库、存储、任务执行、前端这四条,在仓库的架构文档里各有一条 ADR(架构决策记录),写了上下文、备选方案和遗留风险。「进程内线程池」这条后来让我付出了代价:pdfium 不是线程安全的,5 个线程同时解析会让整个进程崩溃。这个坑是我在写这个系列、给仓库补测试的时候才踩到的,第 7 篇细说。
怎么做出来的:28 个小时,21 张任务卡
这个项目是用我自己的 AI 工程治理模板 从零做出来的,算是那套模板的第一个真实落地项目。
时间线很短:第一个提交是 10 月 31 日 16:27,v0.4.0 开源发布是 11 月 1 日 20:35,墙上时钟过了 28 个小时(中间睡没睡觉,git log 不记录)。但顺序一点没乱:
- 先写 PRD,定范围、定红线、每个功能写布尔验收标准
- 再写架构文档和 ADR,再写接口契约
- 然后才拆任务卡,一次只拆三五张,做完一批、验收通过,再拆下一批
- 每张卡都有评测方案,评测不过不标 done
21 张任务卡,56 次提交,到 v0.4.0。写这个系列的时候我又开了第 22、23 张:先修了一批「文档这么说、代码没这么做」的问题,发布成 v0.4.1;再在评测年报上逐份复跑指标,修掉千元单位等 4 个数值问题,发布成 v0.4.2。这个过程本身就是第 1 篇的内容:AI 写代码很快,快到你必须先把「什么算做完」写下来,不然它会很快地做完一件你没要的事。
初代版本的成绩单
仓库带一套评测集:5 家公司 2024、2025 两年共 10 份真实年报,每份配一套金标(标准答案),每次评测的原始输出都存档在仓库的 tests/eval/reports/ 里。v0.4.2 的成绩:
| 评测项 | 结果 | 需求文档门槛 |
|---|---|---|
| 三表定位 | 30/30 | 10 份全对 |
| 数值归一(单位、符号、空值) | 100/100 | 100% |
| 表格还原(行与数字对得上) | 192/200 = 96.0% | 99% |
| 20 项指标可算出 | 194/200(剩下 6 项原文无对应行) | 缺失需显式标注 |
| 指标与金标一致(金标有值的部分) | 118/127(9 条差异逐条核对过,其中 2 条是金标漏取) | — |
| 异常项带页码,且页码与报表一致 | 14/14 | 每条都要有 |
| 测试 | 298 项通过,覆盖率 91.86% | 80% |
有一行没达标:表格还原 96.0%,需求文档定的门槛是 99%。按需求文档自己的规矩,这个数「不达标不发布」,所以它发布的名义是「初代」,CHANGELOG 的已知限制里第一条就写着这个数。剩下的 4% 卡在哪、金标本身为什么也会错,是第 6 篇的内容。
还要先给自己泼盆冷水:评测集只有 5 家科技公司。银行、保险、地产的报表格式和它们差得很远,这套解析规则在那些行业上的表现,我没有数据,不敢说。
v0.4.2 做到了哪
| 状态 | 内容 |
|---|---|
| 已完成 | 年报上传与正文识别、三表定位与表格还原、数值归一、134 项科目对齐、20 项指标、3 条勾稽、8 条异常规则、11 张图、页码溯源、Markdown / Excel 导出、多期会话 |
| 已知缺口 | 表格还原 96% 未达 99%;对齐模块评测 100 分,但主流程没有调用它;未对齐科目没有在页面上列出来;溯源只到页码,不到坐标;导出链接和排队中的任务重启后丢失 |
| 规划中(v1.1) | LLM 科目兜底、扫描件识别、坐标级溯源、半年报、账号与额度 |
每一条缺口的现状、为什么推迟、打算怎么做,第 7 篇逐条写。以后版本更新,这张表跟着改,做完的缺口会变成新的一篇。
5 分钟跑起来
前置条件:Python 3.11+。
git clone https://github.com/zhaoxuejie/moqian-fin-lens.git
cd moqian-fin-lens
python -m venv .venv
source .venv/bin/activate        # Windows:.venv\Scripts\activate
pip install -e ".[dev]"
cp .env.example .env
uvicorn app.main:app --reload # 打开 http://127.0.0.1:8000然后去巨潮资讯网下载一家 A 股公司的年度报告 PDF(要全文,不要摘要),拖进首页上传。想看多年趋势,同一家公司再传两三年的年报就行,最多 5 期。
跑测试:
pytest --cov新克隆的仓库没有评测用的年报 PDF,会是 276 通过、22 跳过;按 tests/eval/pdf/00_财报来源与校验清单.md 把 10 份年报下载放好,才是 298 项全跑。年报原件体积大,也涉及版权,所以不进仓库。
这个系列怎么读
| 篇 | 主题 |
|---|---|
| 0 | 概览:每个数字都能点回原文的年报解析器(本篇) |
| 1 | 开工:28 个小时、21 张任务卡 |
| 2 | 解析:三百页里找三张表 |
| 3 | 对齐:空值不是 0,科目有一百多种写法 |
| 4 | 计算:20 项指标、三条勾稽,只陈列不评价的异常项 |
| 5 | 呈现:页码溯源、11 张图与零构建前端 |
| 6 | 评测:金标也会错 |
| 7 | 初代的账本:已知缺口与路线图 |
v1.1 的计划(LLM 科目兜底、扫描件识别、坐标级溯源等)列在第 7 篇的「规划中」,做完一件,这里加一篇。
按需挑着读:
- 只想用起来:读完本篇,照上面跑起来就够了
- 在做 PDF 表格抽取:第 2、3 篇,都是具体的坑和对策
- 对「AI 协作开发怎么不跑偏」感兴趣:第 1、6、7 篇
代码引用都固定在 v0.4.1 的发布提交上(各篇讲的正是初代版本的样子,之后的修复以「v0.4.2 更新」注明)。仓库以后怎么改,文章里的链接都能点开,行号也对得上。