
开源工具评测:agent-browser 把整页 DOM 压成一份元素清单
一、先算一笔账:让 Agent 看一次网页有多贵
你在 Claude Code 里让它干活:"去后台把那个订单的状态查一下"。
接下来发生的事你大概经历过:Agent 调浏览器的 MCP 工具,拿回来一整页结构。一个普通后台页面,完整的 DOM 快照三万多字符,直接吃掉你上下文的三分之一。再跑两步,前面读的代码就掉出窗口了。
比 token 更烦的是它找不到东西。你给模型几百个嵌套节点,让它自己判断哪个是"提交"按钮,它就得在 <div class="btn-wrapper"><button type="submit" class="ant-btn ant-btn-primary"> 这种字符串里推理。点错了,报错,再重来一遍,又三万字符。
这就是大多数浏览器 MCP 的真实成本:每一步都要重新交一次"整页税"。
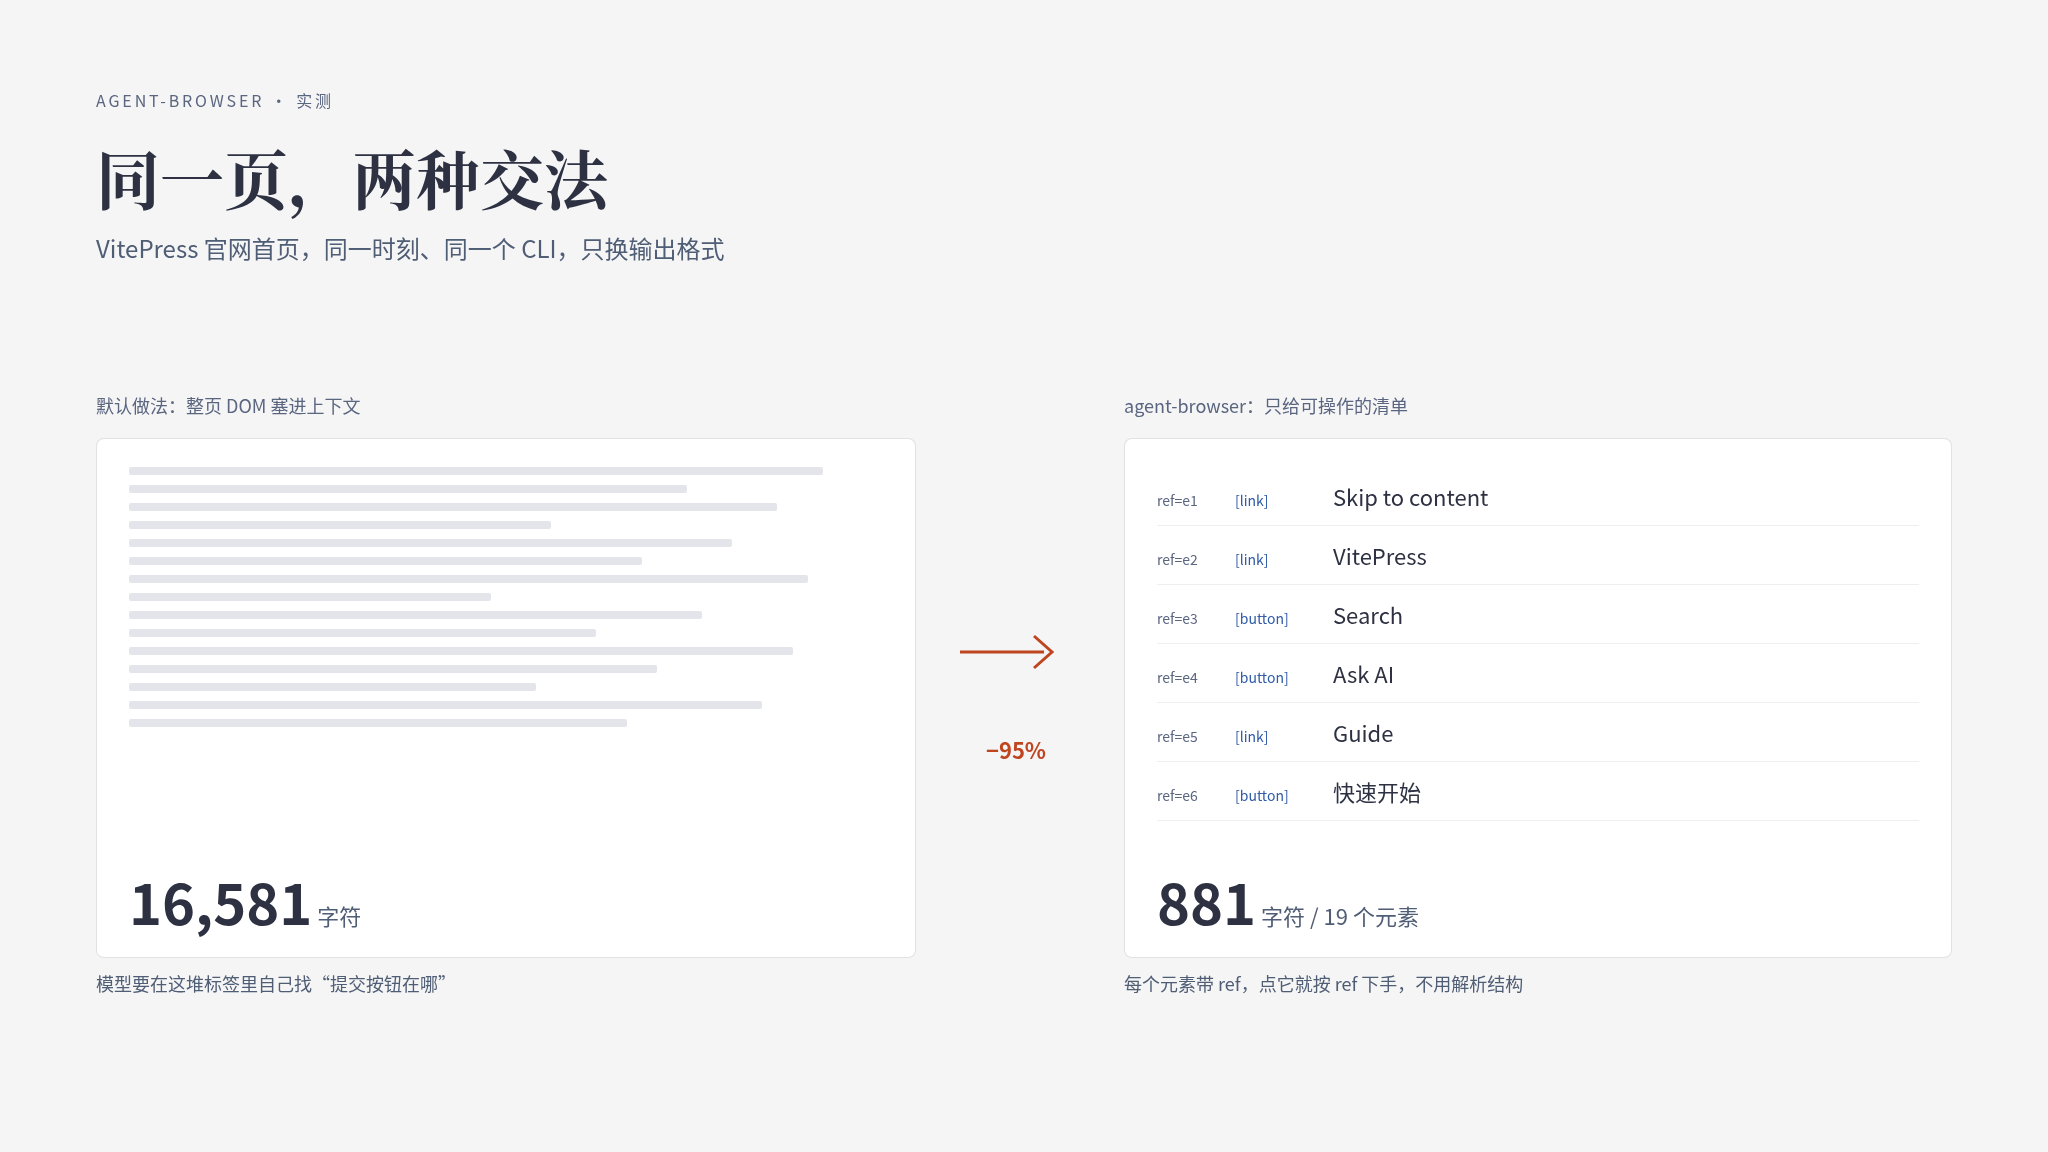
这篇要说的 agent-browser,就是专门来收这笔税的。
二、它解决什么:把网页压成一份带编号的清单
agent-browser(GitHub: vercel-labs/agent-browser)是 Vercel Labs 出的一个 Rust 原生 CLI。它给自己的定位一句话:给 AI Agent 一个能一条命令一条命令驱动的浏览器。
核心就一个命令,snapshot:它不返回 HTML,而是把页面转成一棵紧凑的无障碍树文本,每个元素带一个 ref:
- heading "Example Domain" [ref=e1]
- link "More information..." [ref=e2]
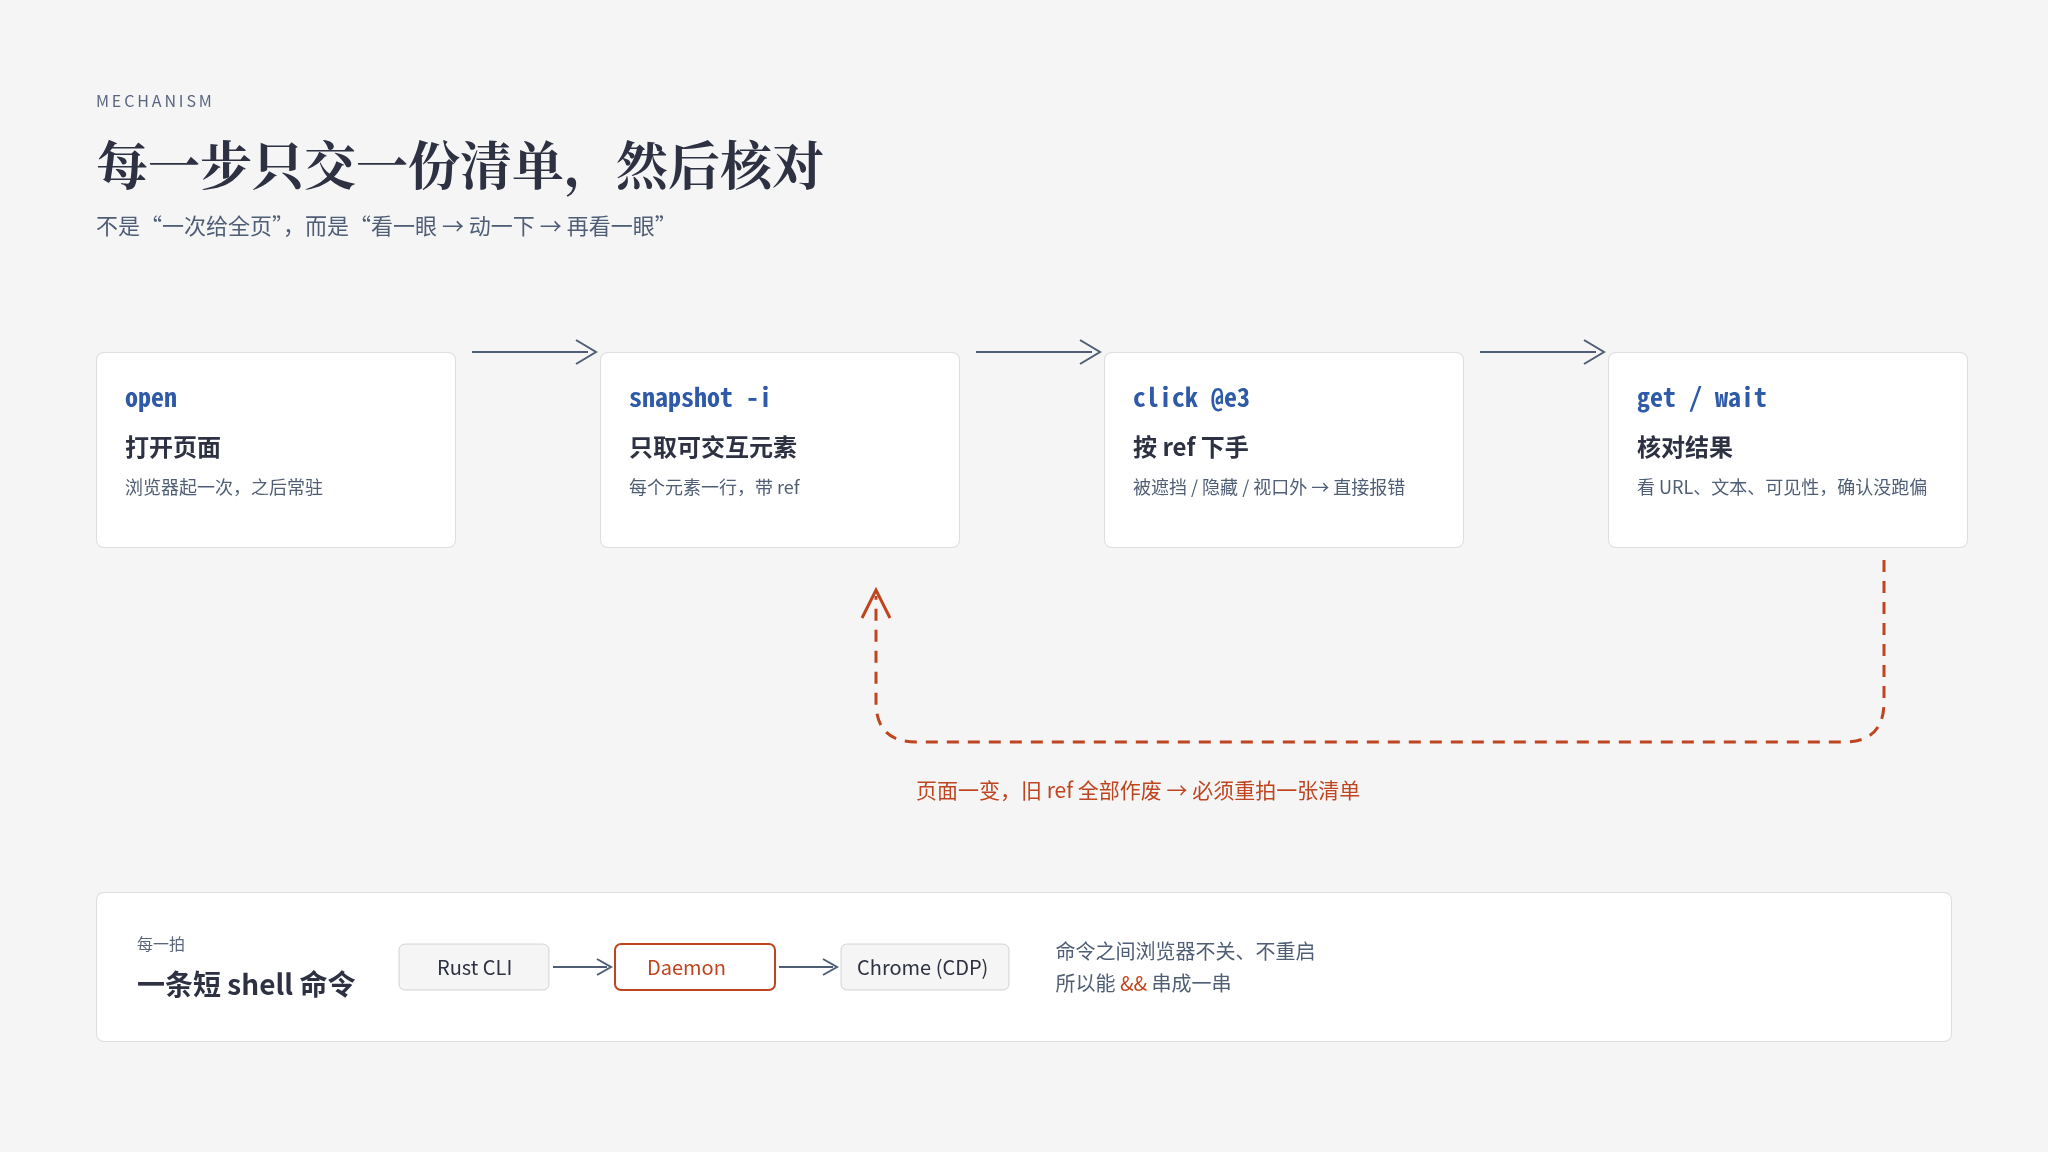
- button "提交" [ref=e3]然后 Agent 就按这张清单办事:click @e3 → 再 snapshot 看结果对不对 → 确认没跑偏,继续下一步。整个过程是一串短 shell 调用,浏览器在命令之间一直开着。
三个设计决定值得单独拎出来说:
第一,浏览器常驻,不是每步重开。 CLI 把每条命令发给一个后台 daemon,daemon 通过 Chrome DevTools Protocol 控着浏览器。所以你可以 open && wait && snapshot 用 && 串成一次调用,中间不用等浏览器冷启动。
第二,点不到就报错,不假装成功。 目标元素被隐藏、被禁用、在视口外、或者被 consent 弹窗盖住,命令直接失败。这条看着像缺点,其实是整套方案可信的根基——它逼着 Agent 处理真实情况,而不是收一句"操作成功"然后继续往下错。
第三,ref 是"那一刻"的坐标,过期就作废。 页面一跳转、DOM 一变,旧 ref 全部失效,必须重新 snapshot。这既是它的安全边界,也是它最烦人的地方,后面讲局限会展开。
规模摆在这儿(GitHub 实时数据):
| 项 | 值 |
|---|---|
| Star / Fork | 47.2k / 3.2k |
| Commits | 818,最新一条 9 小时前 |
| 最新版本 | v0.41.2,四天前 |
| 协议 / 语言 | Apache-2.0 / Rust |
| 上线 | 2026 年 1 月,十个月从 0 到 45k |
一千多个 tag、四天一个版本,这是典型的"高频迭代、接口还会变"的项目状态。
三、我自己测了三组页面,结果和宣传不太一样
官网说快照"约 200–400 tokens",而完整 DOM 是"3000–5000"。我不太信这种整数,就装了一份实测(v0.27.0,Linux,Chromium 146 本地 CDP)。
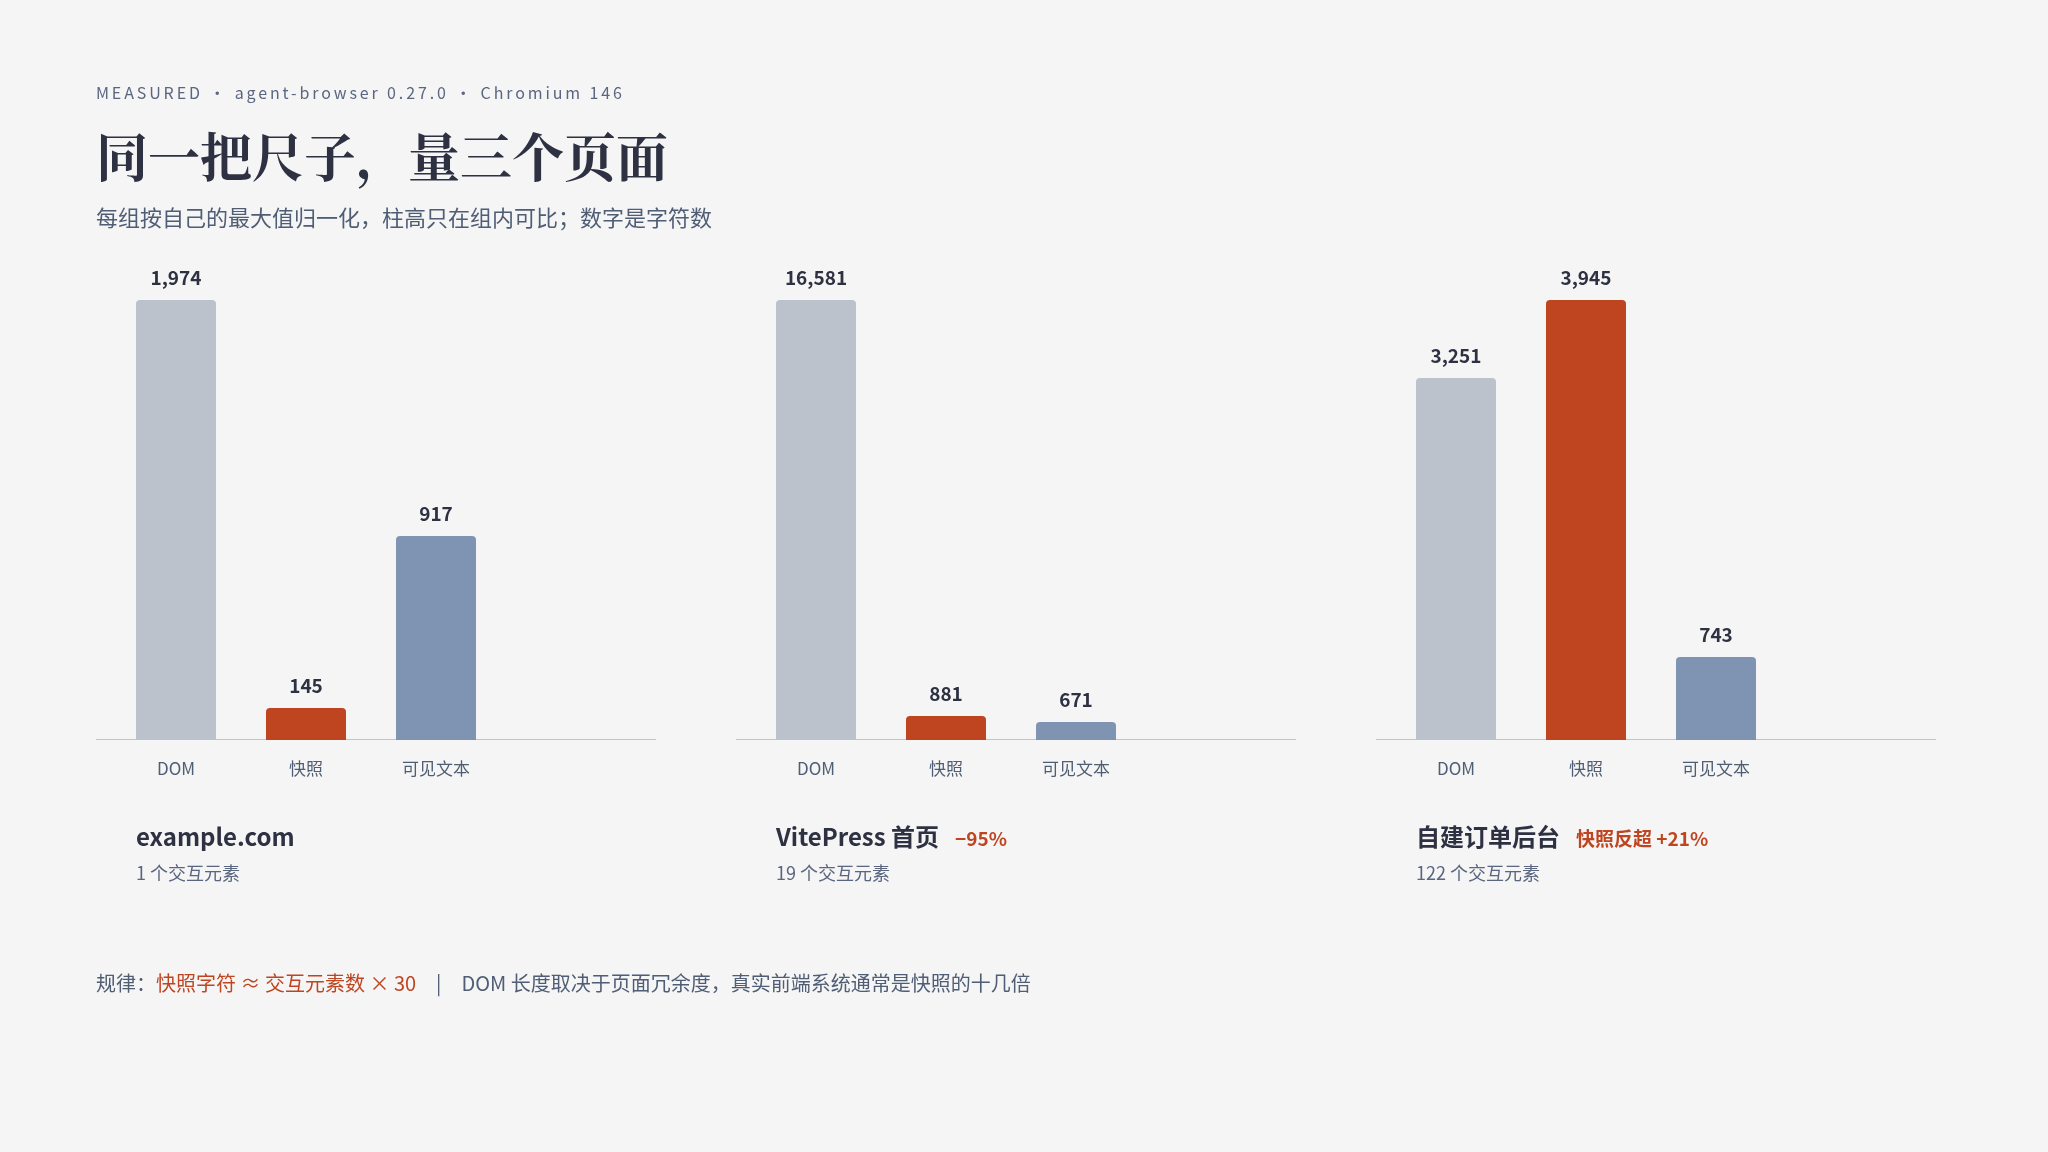
同一时刻、同一个 CLI,只换页面,量三组数:
| 页面 | 交互元素 | 快照文本 | 完整 DOM | 页面可见文字 |
|---|---|---|---|---|
| example.com | 1 | 145 字符 | 极小 | 极少 |
| VitePress 官网首页 | 19 | 881 字符 | 16581 字符 | 671 字符 |
| 自建订单后台(12 行表格) | 122 | 3945 字符 | 3251 字符 | 743 字符 |
三组数字讲了三件事:
第一,宣传数字是真的,但有前提。 VitePress 首页 881 字符,按英文四字符一个 token 粗算约 220 token,正好落在官网说的区间。它省掉的确实是 16581 → 881,95% 没了。
第二,快照的体积基本由"元素个数"决定,跟页面大小关系不大。 平均一个元素约 30–32 字符。19 个元素就是 881,122 个元素就是 3945。这是线性增长的。
第三,元素一多,快照会反超 DOM。 我那个 12 行表格、每行两个按钮的后台页,快照 3945 字符,而整页 HTML 才 3251——快照比 DOM 还长 20%。原因是我的页面 HTML 写得太干净,没有真实前端框架那堆 class、SVG、嵌套;真实业务系统里 DOM 动辄两万字符往上,这种情况快照还是划算。但如果是元素极其密集的页面(大表格、看板、日历),快照未必省,甚至会超。
所以那句"省 94% token"要打折看。第三方几份 benchmark 更能说明这行水分多大:
| 来源 | 口径 | agent-browser | 对照组 |
|---|---|---|---|
| isagentready | 10 步流程估算 | ~7,000 | Playwright MCP ~114,000 |
| browser-use(自家产品评测) | 单任务输入 token 中位数 | 3.3M | Playwright MCP 4.4M |
| openbrowser | form_fill 任务 | 19,226 | playwright-cli 31,757 |
同一件事,三份数据分别说"省 94%"、"省 25%"、"省 39%"。口径不同(单次快照 vs 整个任务 vs 多次重试),差了一个数量级。 我不会在文章里选一个最好看的数字当结论——你自己测一遍比看任何 benchmark 都强。
它真正省的不是字节,是**"理解成本"**:DOM 里九成是样式和标签噪音,模型要在里面推理;快照直接把"能点的东西"和它的名字摆出来,模型不用解析,照着 ref 下手就行。
四、3 分钟上手
装:
npm install -g agent-browser
agent-browser install # 首次下载 Chrome for TestingmacOS 也可以 brew install agent-browser。Linux 上如果是干净容器,用 agent-browser install --with-deps 连系统库一起装。不想装就 npx agent-browser open example.com。
已经装了 Chromium 的话不用再下 Chrome,指过去就行:
agent-browser open example.com --executable-path /usr/local/bin/chromium-browser第一条完整流程:
agent-browser open example.com
agent-browser snapshot -i          # 只看可交互元素,每个带 ref
agent-browser click @e1            # 按 ref 操作
agent-browser get url              # 核对结果
agent-browser close-i 是常用的,它只筛可交互元素,能把快照再压掉一截。核对结果也可以用 get text @e1、is visible @e1、screenshot。
对 Agent 这件事,它做了一件聪明事。 不是扔一份 AGENTS.md 让你自己抄命令,而是把用法做成 skill,跟 CLI 版本绑定:
agent-browser skills get core        # 核心循环、ref、等待、常见流程
agent-browser skills get core --full # 加上完整命令参考和模板npx skills add vercel-labs/agent-browser 装进去的那个 skill 只是一个很薄的 stub,内容是"先跑 agent-browser skills get core 再照做"。这样 CLI 升级了,Agent 读到的说明永远是最新的,不会拿半年前的命令去撞新版接口。
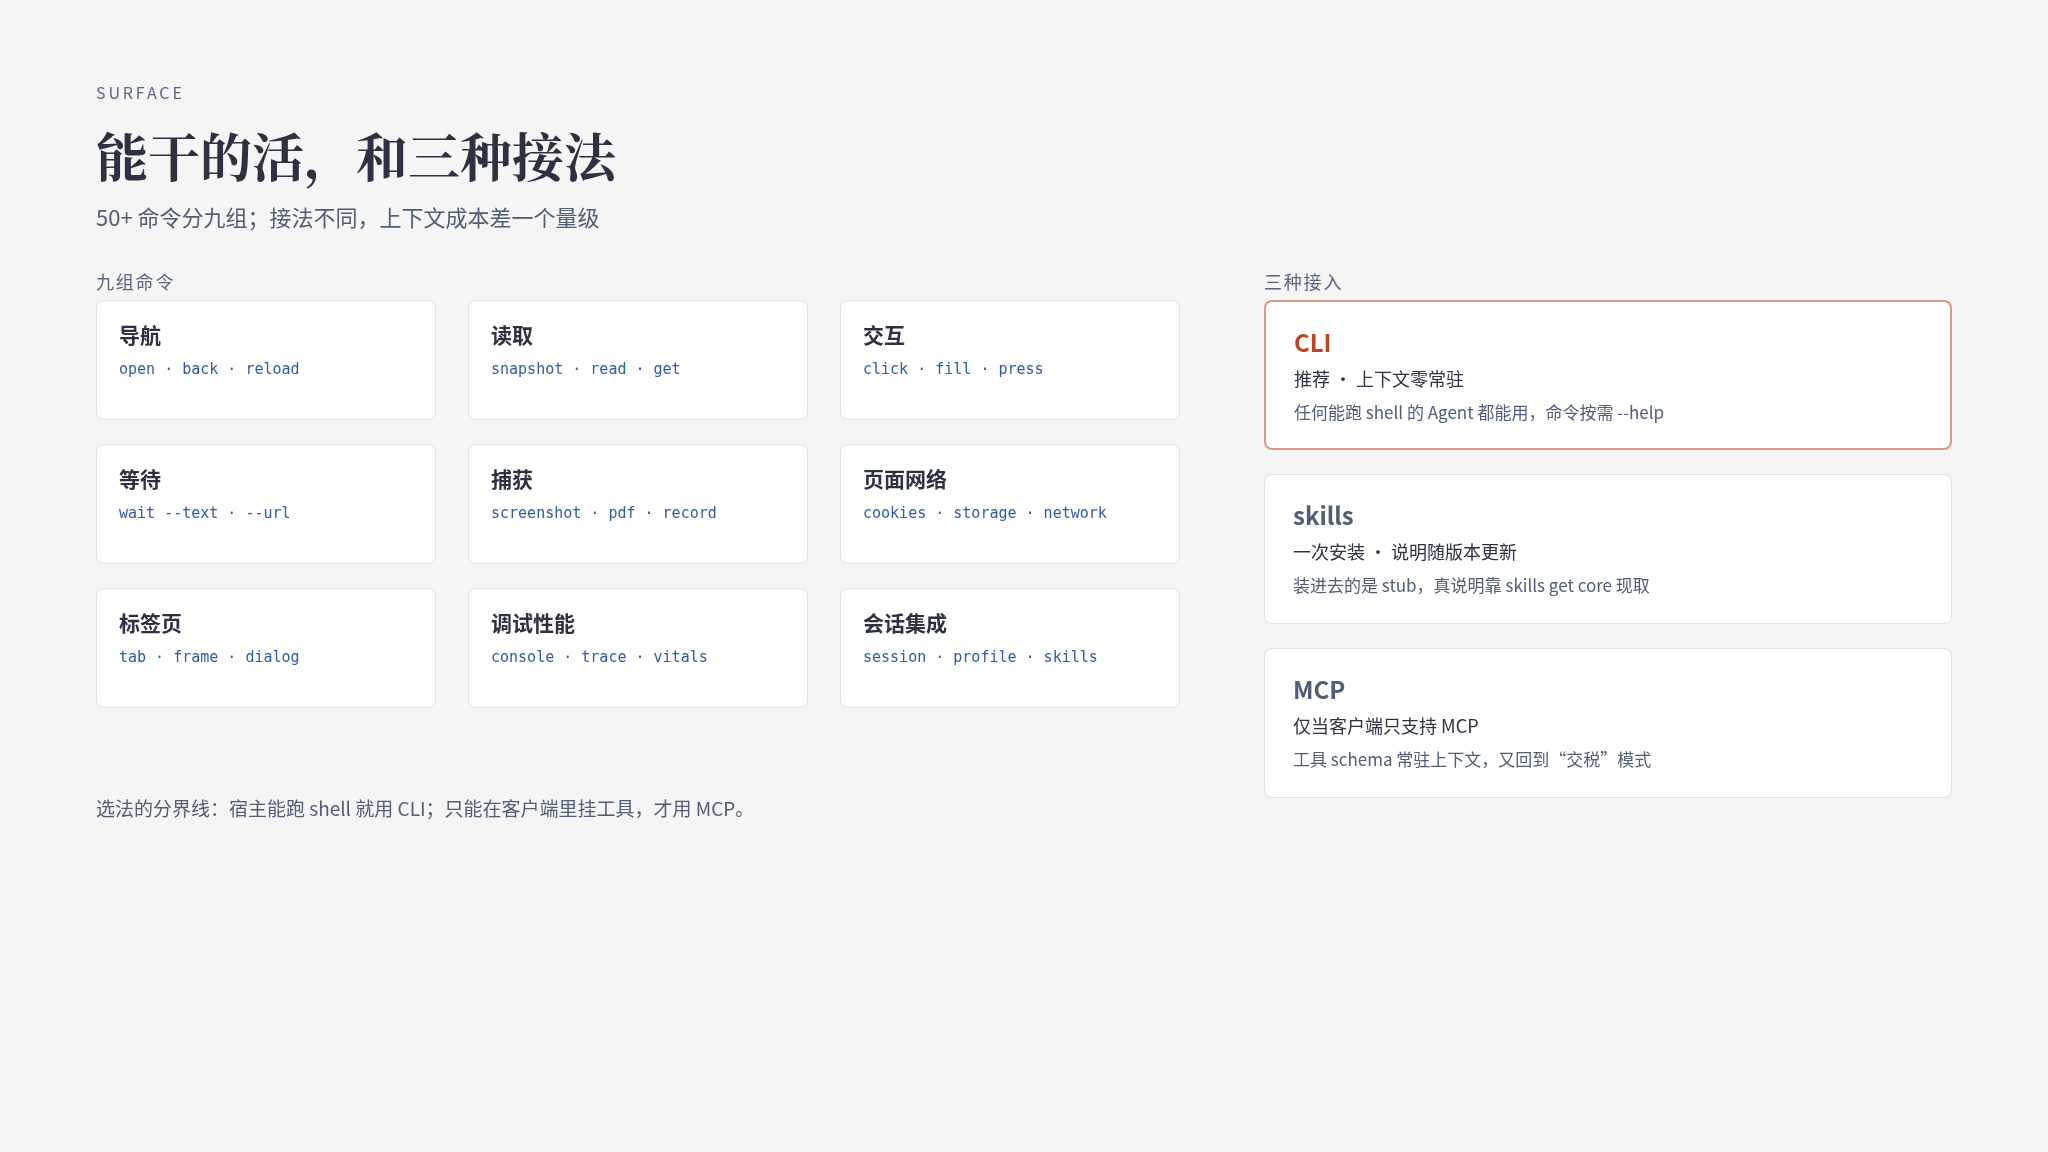
三种接入方式,按场景选:
| 方式 | 适合 | 代价 |
|---|---|---|
| CLI(推荐) | 任何能跑 shell 的 Agent | 无工具 schema 常驻成本 |
| skills | Claude Code / Cursor 等支持的宿主 | 需要一次 skills add |
MCP(agent-browser mcp) | 只支持 MCP 的客户端 | 工具定义常驻上下文,回到"交税"模式 |
这也是它敢叫"给 Agent 的 CLI"的原因:MCP 的工具 schema 是常驻成本,CLI 的 --help 是按需成本。 在上下文紧张的宿主里,这个差别很实际。
还有几个实测中体会到的细节:
wait别无脑用networkidle。官方文档自己写了:SSE、WebSocket、轮询、长轮询的页面可能永远安静不下来。用wait --text "欢迎回来"、wait --url "**/dashboard"这种"等结果"的条件更可靠。&&串起来是安全的,因为 daemon 常驻。不需要中间结果就串,需要先看 snapshot 拿 ref 就分开跑。- 调不通的时候
agent-browser doctor会告诉你环境哪里不对(我这儿就是它查出来的:CDN 拉不到、但本地 Chromium 可用,7 项 pass、1 项 fail,一眼定位)。
五、一个完整的活例子:登录后台查一张订单
场景:一个需要登录的订单后台,要查某个客户最近一单的状态。
第一步,把登录态解决掉。别每次从头填——它支持 profiles 和 auth(凭证可以挂系统钥匙串或 vault),登录一次存下来,后续命令带着 profile 走。
agent-browser open https://admin.example.com/login
agent-browser snapshot -i
# - textbox "账号" [ref=e1]
# - textbox "密码" [ref=e2]
# - button "登录" [ref=e3]

agent-browser fill @e1 "ops@example.com"
agent-browser fill @e2 "..."
agent-browser click @e3
agent-browser wait --url "**/dashboard"进到列表页后,关键是先看清单再动手:
agent-browser snapshot -i
# - textbox "订单号 / 手机号" [ref=e2]
# - button "查询" [ref=e7]
# - button "查看" [ref=e12]填条件、查询、重新快照(因为表格内容变了,旧 ref 已经作废),再从新清单里点"查看",最后取文本:
agent-browser fill @e2 "13800138000"
agent-browser click @e7
agent-browser wait --text "共 1 条"
agent-browser snapshot -i
agent-browser get text @e14整个流程里,Agent 真正"看"到的只有几次短清单,没有一次把整页塞进上下文。哪一步失败它会立刻知道——因为点不到就是点不到,不会收到假的成功。
这个流程是按文档和实测整理的,字段随你的系统改。 我用的测试页是本地造的,不是真后台,这点我得说清楚。
六、客观优劣
✅ 优势
- 上下文的账算得清:普通页面 220 token 一屏,比塞整页 DOM 省一个数量级;元素多的页面会打折,但至少你自己能量出来
- 失败即失败:点不到、被遮挡直接报错,Agent 无法自欺,重试逻辑才写得对
- 浏览器常驻 +
&&链式:一条命令一步,不像每步重开浏览器那样慢 - 覆盖得全:50+ 命令,导航、表单、等待、截图、PDF、录视频、网络拦截、cookies/storage、标签页/iframe、console/errors、profiler、vitals 都有
- 不只控一个自带浏览器:能挂你已经开着的 Chrome(
--cdp/--auto-connect),能换 Lightpanda、Obscura 引擎,能接 Browserbase / Browserless / Browser Use / Kernel 这些云浏览器 - skill 跟着版本走:stub +
skills get core的设计,升级不会读到过时命令 - 原生二进制:macOS / Linux / Windows 都有,不依赖 Node 运行时
⚠️ 局限
- ref 天生易碎:页面一变就得重新快照,交互轮次天然增加,一个二十步的流程可能拍十几次快照
- 元素密集的页面不省:我实测 122 个元素的表格页,快照字符数反超整页 HTML
- 反爬绕不开:headless 的指纹(webdriver 标记、渲染特征)会被 Cloudflare、Vercel BotID 这类系统识别,要过就得配凭证库、云浏览器或验证码插件——这已经是另一门手艺
- 版本太新,接口不稳:120 多个 tag、四天一版,v0.41 和半年前的写法可能不兼容,别在关键链路上裸奔
- 不是测试框架:它没有断言、并行、fixture、报告那套东西。写端到端测试还是 Playwright
- 首次安装有体积:要么下 Chrome for Testing,要么自己指一个 Chromium;Linux 容器还要
--with-deps装系统库
七、结尾
agent-browser 的价值不在"能开网页"——能开网页的工具太多了。它的价值在于把"Agent 看网页"这件事的单位从"一页"改成了"一个元素"。
这个改动带来三件事:上下文可预测、操作可校验、失败可感知。剩下那些"省 94% token"的宣传数字,是这门改动在最理想情况下的副产品,不是它的本质。
什么时候用它:你在 Claude Code / Cursor 里让 Agent 顺带看一眼网页——查个后台、抓个数据、跑一遍注册流程、给页面截个图做验收,而且上下文本来就紧张。
什么时候别用它:要写稳定的端到端测试(用 Playwright);需要"看一眼截图自己判断"的视觉型任务(用 browser-use 那类);要过强反爬站点(先解决指纹问题,工具只是最后一块)。
仓库:https://github.com/vercel-labs/agent-browser
最后一句大实话:这类工具今年会冒出一堆,判断哪个靠谱的标准不是它有 50 个还是 100 个命令,而是它失败了会不会告诉你。agent-browser 在这点上做得比大多数同类硬。