
开源工具评测:rea-video 把爆款视频拆回生产线
一、痛点:看到爆款视频,只会"照着做"却不知道为什么
刷到一条爆款带货视频、AI 短片、3D 科普动画,第一反应是"我也能做一条"。
真动手就发现不知道从哪下手:这条是实拍还是 AI 生成的?拍了几个机位?花字怎么出场的?配乐是曲库的还是 AI 做的、多少 BPM?剪辑卡的是哪一拍?
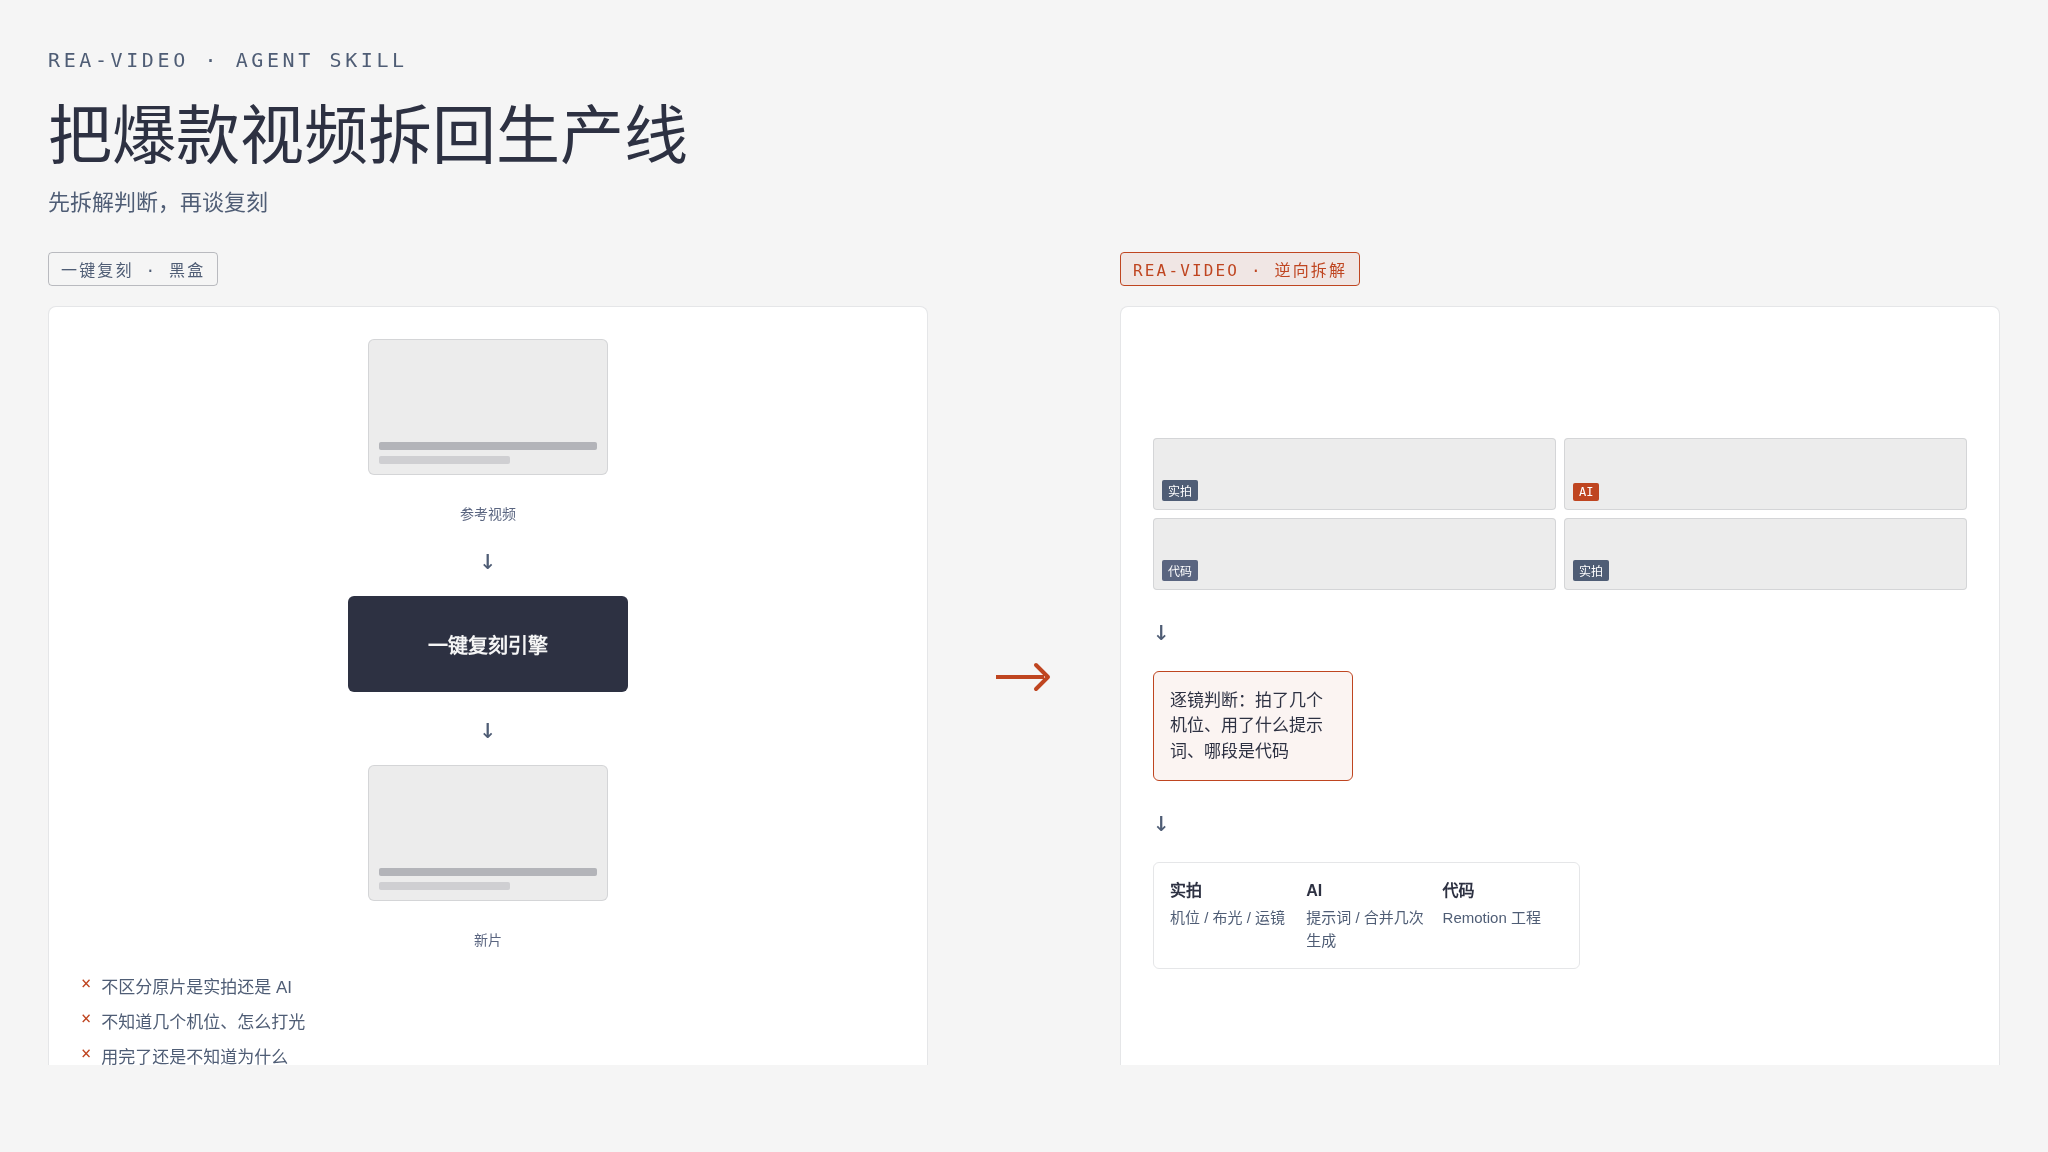
市面上的"一键复刻"工具(比如 Hypit)拿一条参考视频就能直接生成新片。但它们大多是黑盒:不区分原片是怎么做的,实拍的照样按自己的流程重做,也不会告诉你原片几个机位、怎么打光。你用完了还是不知道为什么。
想省钱做同款,前提是先搞清楚:哪部分是拍的、哪部分是 AI 生的、哪部分是代码做的。 不同的部分,做法和成本完全不一样。
rea-video 就是干这个的——先拆解、判断,再给方案,最后才谈复刻。
二、它解决什么:给 AI 装一双"逆向之眼"
rea-video(GitHub: JuneYaooo/rea-video)是一个跑在 Claude Code、Codex 这类 Agent 里的 Agent Skill,定位一句话:逆向一切视频。
它不直接出片,而是把一条视频按镜头拆开,逐个镜头告诉你画面、花字、剪辑和声音是怎么做的,再告诉你怎么照着做一条。
图片里标注它是新项目——24 小时 +461 星、总 813(README 里没有静态数字,用动态 badge)。作者是 JuneYaooo,思路致敬 REA(Reverse Engineer Anything):从现象追到实现,结论附证据。
能拆哪些视频:
| 视频类型 | 常见例子 | 拆出什么 |
|---|---|---|
| 实拍 | 口播、桌拍、手持带货、vlog、探店 | 拍摄场次和机位,景别、运镜、布光(12 种方案附器材)、调色 |
| AI 视频 | 文生/图生视频、AI 短剧、AI MV | 判断依据,每镜反推的提示词,合并成几次生成、用哪个模型 |
| 数字人 | 人像被声音驱动说话、对口型 | 哪些镜头是数字人,需要的人像和音频 |
| 3D / 动画 | Blender/C4D 科普、产品动画、2D 动画、定格动画 | 用视频模型生成还是写 3D 代码渲染 |
| 代码 / 模板 | 文字动效、UI 演示、图表、PPT 式卡片 | 文字、版式、动效节奏,可以写成 Remotion 工程 |
| 录屏 / 截图 | 软件教程、网页演示 | 哪些是真实素材,复刻时要你自己录 |
| 混合 / 混剪 | AI 人物 + 代码界面 + 真实录屏、实拍口播 + AI 带货段 | 每一镜分开判断,再按原时间线拼回 |
除了画面,每条视频还会拆出:字幕花字(每句起止时间,可导出 SRT/ASS,花字颜色、描边、出场方式)、贴纸表情包画中画(放在哪、停多久)、剪辑(在哪切、节奏多快、有没有卡节拍)、声音(真人还是 AI 配音、配乐是 AI 做的还是曲库、多少 BPM、音效落在哪一下),以及要你自己准备的素材(录屏、截图、产品图)。
三、3 分钟上手
前置条件:电脑上要有 ffmpeg 和 Python 3.10 以上。
rea-video 不是独立 GUI 工具,是给 AI 助手用的。在 Claude Code、Codex 这类能运行命令的 Agent 里,直接说一句话:
安装 https://github.com/JuneYaooo/rea-video ,然后拆解这条视频:/path/to/video.mp4Agent 会自己装好命令行工具、读完拆解流程,从头跑完。
跑完拿到三样东西:
- 一句话结论:比如"AI 视频 41% + 代码界面 59%,有 8 秒真实录屏,曲库配乐 122 BPM"
- 复刻方案:按实拍、AI 生成、代码分开写
- 完整报告
report.html:逐镜头截图、判断依据、提示词、拍法和声音拆解
要不要配看视频的模型? 不一定。只用工具是离线、免费的,原始文件准确率已经很高。从平台下载、压缩过的视频建议配一个能看视频的模型(Gemini、豆包都行),把接口地址和密钥告诉 Agent 就行。配上之后实拍、AI、3D 分得更准,每个镜头还会反推出提示词。不配也能用——Agent 自己能看图的话,会补看没把握的镜头。
四、它怎么判断的:硬证据优先于"看起来像"
拆解流程分四步:
- 切镜头:把视频按镜头切开,声音拆成人声、配乐、音效
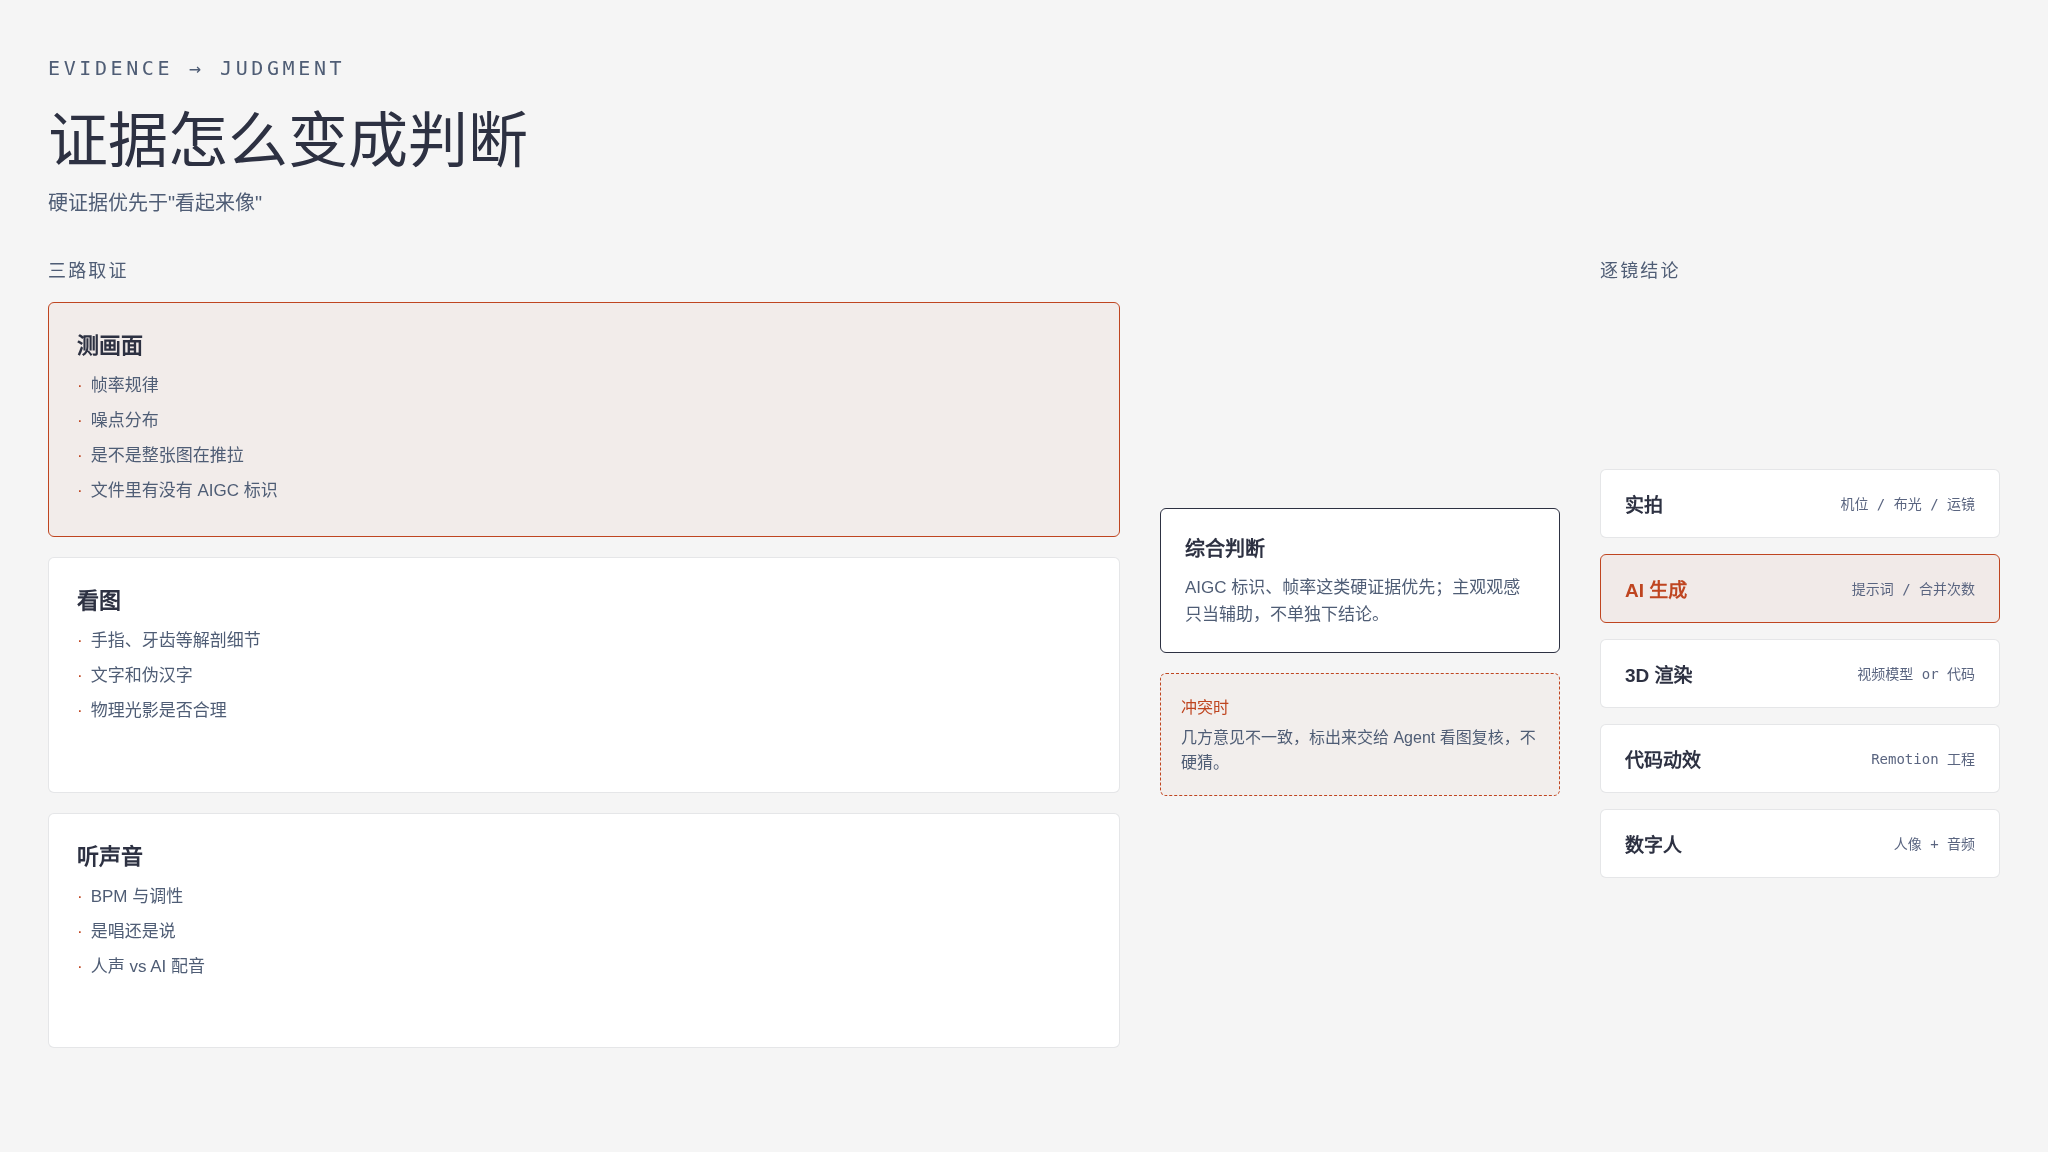
- 取证据:测画面(帧率规律、噪点、是不是整张图在推拉、文件里有没有 AIGC 标识);看图(手指、文字、物理细节对不对);听声音(BPM、调性、是唱还是说)
- 综合判断:AIGC 标识、帧率这类硬证据优先于"看起来像"。几方意见冲突时标出来,交给 Agent 看图复核
- 出复刻方案:按目标视频模型的实际能力分批——单次能生成多长、能不能一次出多个镜头、能吃几张参考图
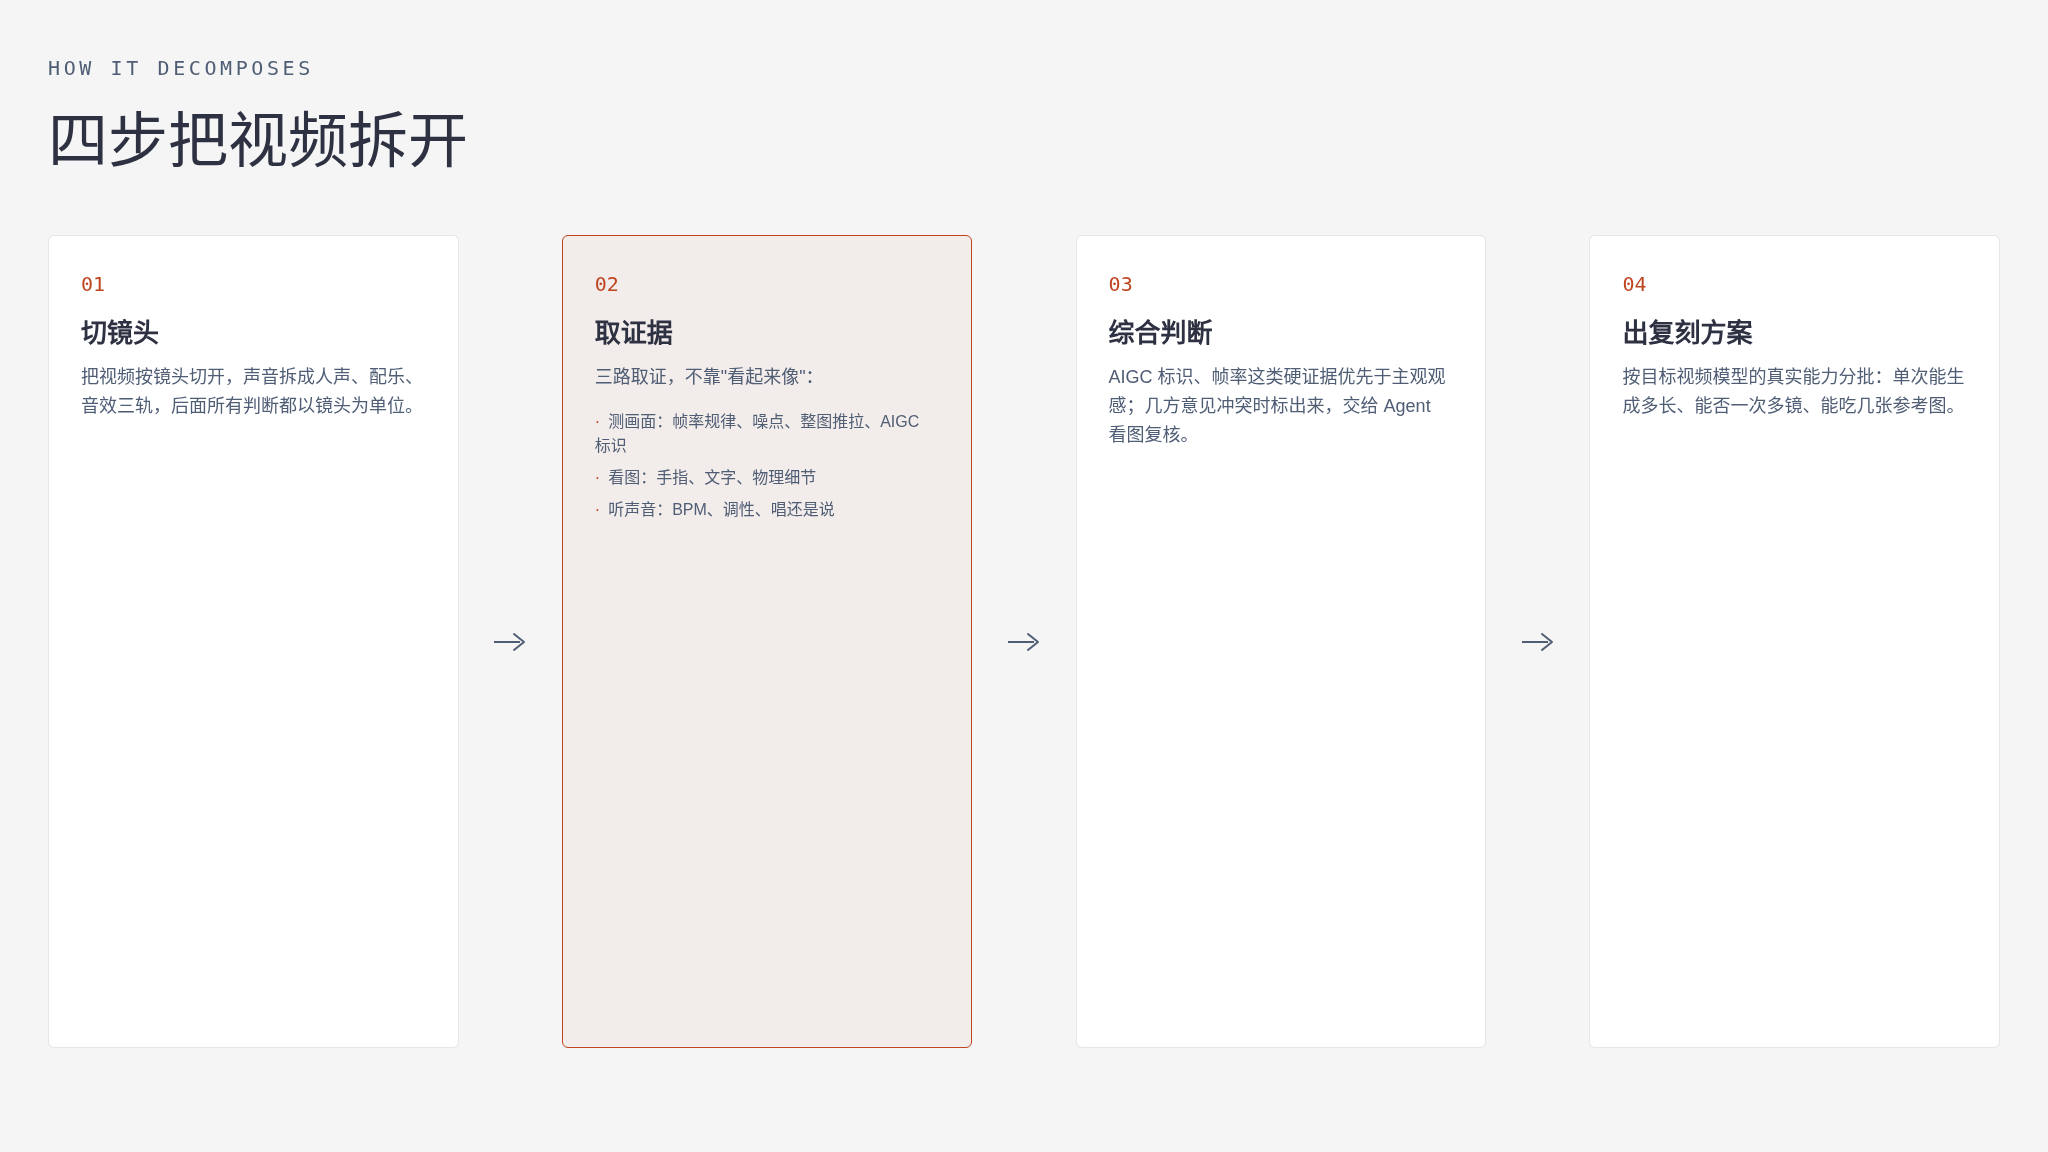
这套逻辑比"让模型看几帧猜一下"靠谱的地方在于:证据链可查。报告里每个镜头都附判断依据,不是一句"我觉得是 AI"。
五、真实案例:它真能从画面里认出来
README 里的几个案例挺能说明问题:
- AI 音乐 MV(165 秒、86 镜):看图模型把好几个镜头判成"影视剧实拍",Agent 最后从奏折上的伪汉字认出是 AI 生成的;还判出歌是 Suno 做的
- 实拍开箱带货(72 秒、29 镜):全部实拍,但转码后工具把 35% 判成 AI;Agent 看图复核后,97% 实拍
- 产品宣传片(70 秒、12 镜):83% 是代码动效、12% 录屏——不需要视频模型,写一个 Remotion 工程就能做
- AI 与真人混合(58 秒、21 镜):实拍 75% + AI 25%,靠即梦水印和礼盒乱码认出 AI 段
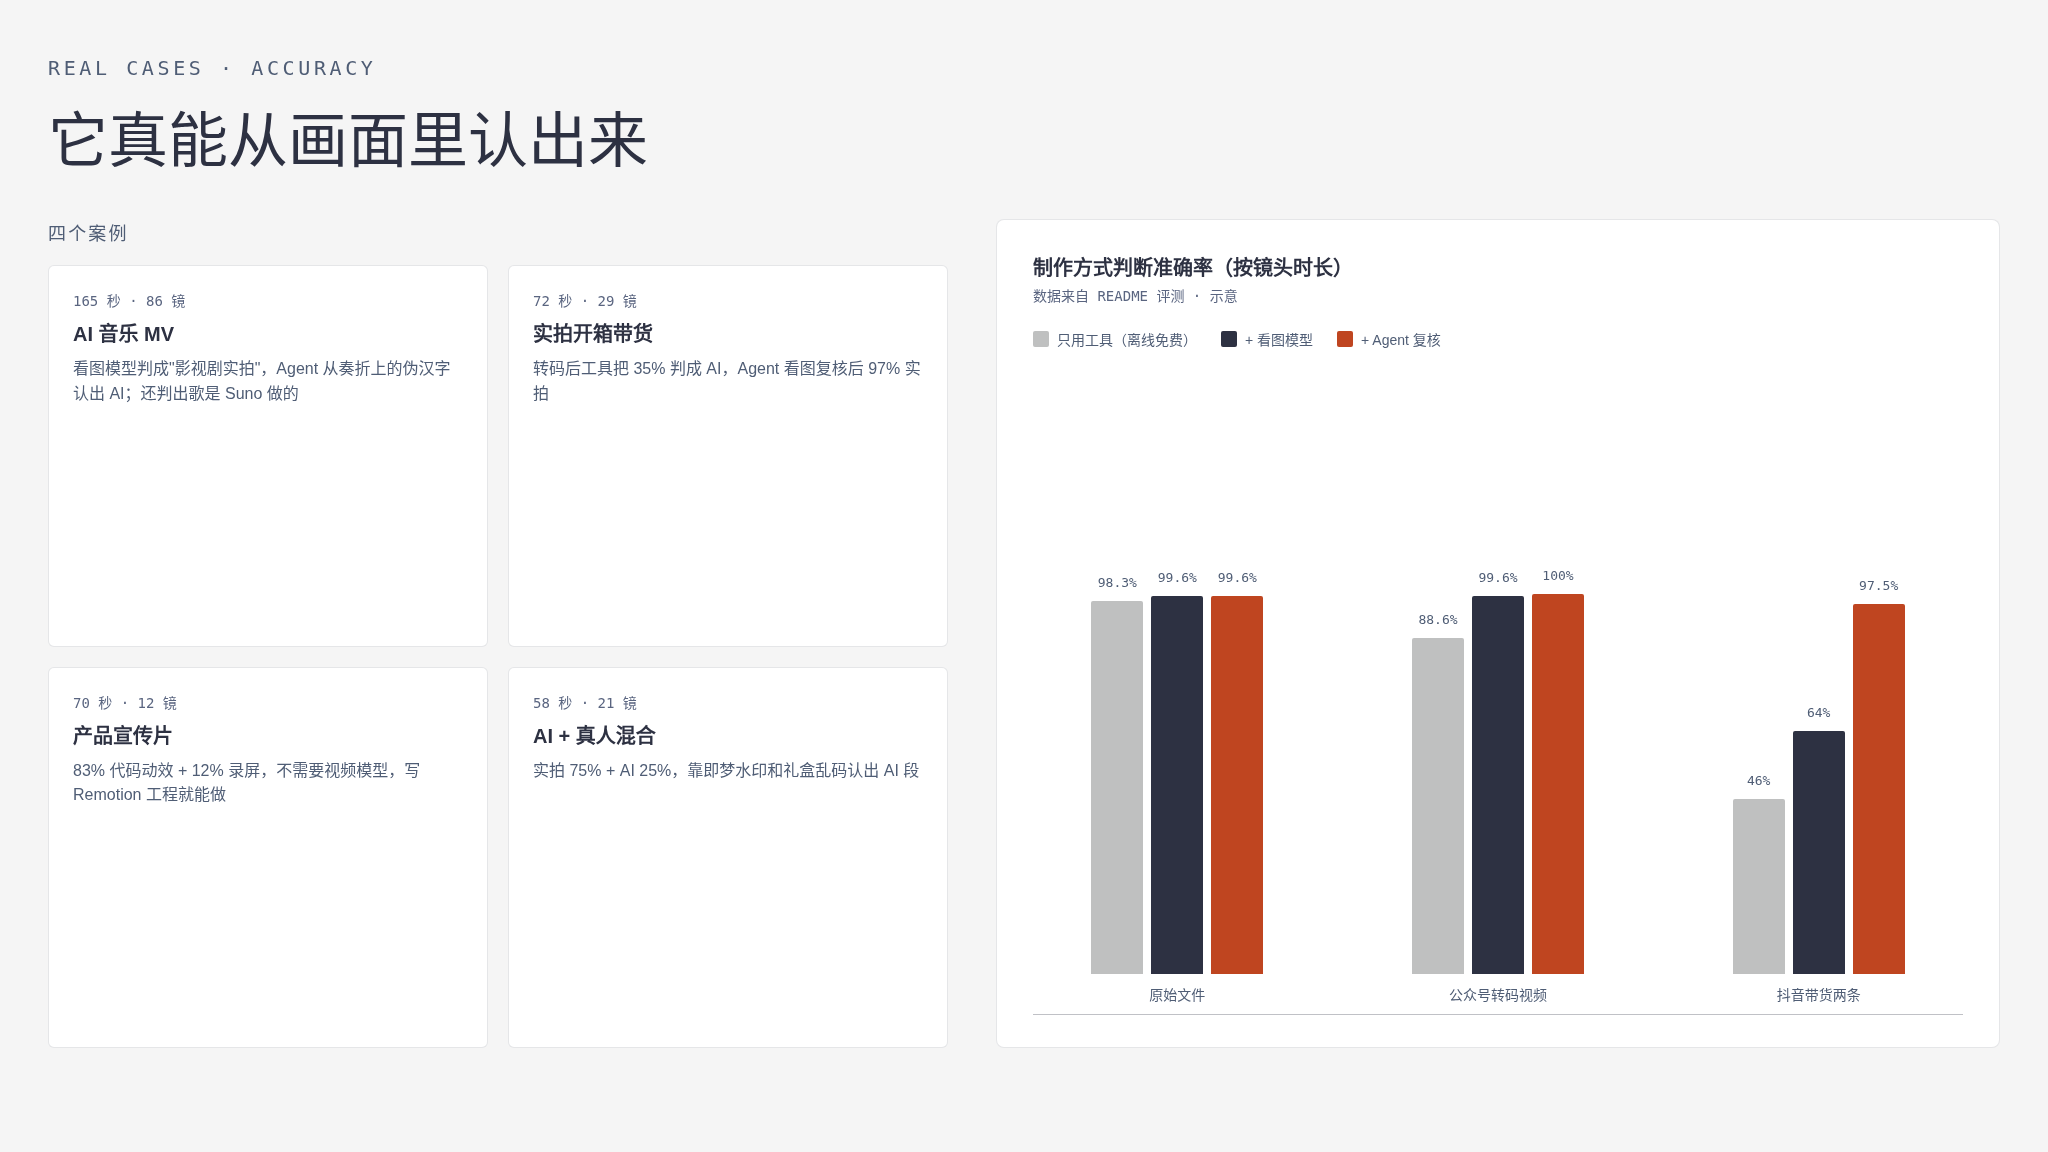
准确率(按镜头时长算的制作方式准确率):
| 场景 | 只用工具(离线免费) | + 看图模型(Gemini) | + Agent 看图复核 |
|---|---|---|---|
| 原始文件 | 98.3% / 99.6% | 99.6% / 99.8% | 99.6% / 99.8% |
| 公众号转码视频(10 条) | 88.6% | 99.6% | 100% |
| 抖音带货两条 | 46% | 64% | 97.5% |
真实素材识别 97–99%,镜头切点全对。拍真实手机屏幕的画面工具会判成 3D/AI,这是目前要靠看图纠正的主要场景。
六、客观优劣
✅ 优势
- 不是黑盒出片:先拆解判断再给方案,你能真正学到原片的结构和做法
- 能省钱:知道哪部分不用生成、哪部分写代码就行,复刻成本心里有数
- 证据链可查:
report.html逐镜头截图 + 判断依据 + 提示词,不是拍脑袋 - 离线免费也有高准确率:原始文件只用工具就有 98%+;配看图模型更稳
- 和复刻工具互补:拆完可以交给同作者的
cheap-claude-video做"换元素复刻"——运镜、动作、节奏、声音跟原片走,只换人/产品/场景 - 覆盖面广:实拍、AI、数字人、3D、代码动效、录屏、混剪都能拆
⚠️ 局限
- 不直接出片:想马上做一条同款,还得自己拍 / 自己生成 / 自己写 Remotion
- 依赖 Agent 环境:跑在 Claude Code、Codex 这类能执行命令的助手,不是双击就能用的桌面软件
- 有环境门槛:ffmpeg 和 Python 3.10+ 得自己装好
- 压缩视频会误判:平台转码后噪点证据丢了,必须靠看图模型或 Agent 复核
- 新项目:生态、稳定性、文档完善度还在早期,判断规则也在持续调
七、结尾
rea-video 的价值不在"帮你做一条新片",而在把视频从黑盒变成可读的生产线:哪一镜是拍的、哪一镜是 AI、哪一镜是代码,各自要花什么成本。
想马上出片,用 Hypit 这类一键复刻工具更快;想搞清原片怎么做的、怎么少花钱做出来,用 rea-video。两个可以一起用。
仓库:https://github.com/JuneYaooo/rea-video
最后提醒一句:它用来学习结构、节奏和做法,再用你有权使用的素材重新制作——别直接搬运别人的画面、音乐、角色或肖像,投放时也要遵守平台的 AI 生成内容标识要求。