
售后知识助手:做一个会说「我不知道」的 RAG
上午九点四十二分,示例大厦 1 号梯停了。工单上客户的原话是:「电梯运行到 6 层附近时,轿厢里能听到周期性『咯噔』声,控制柜闪过几次 HY-E006,今天早上声音变大,已停梯。」
维保工程师李伟九点五十五分到现场,打开平板。他要找的东西散在四个地方:乘客电梯维修保养手册(PDF)、两份按批次区分的补遗、故障码摘编,还有一张历史维修工单台账。最快的办法当然是给老陈打电话。老陈在宏远电梯干了二十年售后,HY-E006 这种故障,他听声音就能猜个七八成。
问题是老陈的手机是全公司响应最快的知识库,也是唯一一个会下班、会休年假、会在另一个现场钻井道的知识库。
这个项目要做的,就是把老陈脑子里能写成文档的那部分经验变成一个随叫随到的助手。而且它说的每一句话,都必须标得出出处。
宏远电梯、李伟、老陈都是虚构的。仓库自带的 30 份演示语料(手册、FAQ、工单台账)也是按真实售后资料的结构虚构出来的,不含任何真实客户数据。
为什么不是「把手册丢给大模型」
做个 RAG Demo 现在只要一个下午:切块、向量化、检索、拼提示词,大模型的回答看着头头是道。真到售后现场,麻烦在于答错的代价。
还是 HY-E006。故障码摘编里写的处置步骤之一是测量制动衬与制动轮的间隙,按批次执行:
| 批次 | 制动器型号 | 单侧间隙标准 |
|---|---|---|
| B22 及以前 | DZS-2 | 0.30~0.50 mm,低于 0.30 须检查制动衬磨损 |
| B23 及以后 | DZS-3 | 0.20~0.40 mm |
假设李伟面前是一台 B22 批次的梯,塞尺量出来 0.25 mm。按 B22 的标准,这台梯的制动衬可能已经磨损了,得查;按 B23 的标准,它「完全正常」。一个把两份补遗混在一起回答的模型,很可能自信地告诉他 0.20~0.40 mm 都没问题。抱闸是电梯上最不能出错的部件之一,这种答案比「我不知道」危险得多。
所以在写第一行代码之前,我先定了几条规矩。它们后来都写进了代码注释,编号叫「纪律」:
- 每条结论必须带可核对的引用,编造的引用整条剥离
- 设备型号、批次这类条件不知道就留空,系统不猜
- 证据不足必须拒答,转人工,同时把这个问题记进知识缺口
- 带电作业、短接安全回路这类安全话题,不生成任何操作步骤,只给安全提示和联系方式
- 同一问题命中多个批次的资料时并列展示,不替工程师做选择
- 现场的新经验要人工确认之后才能入库
这几条有个共同点:都不能交给提示词。你可以在提示词里写一百遍「不知道就说不知道」,模型照样会在证据不够的时候尽力给你凑一个答案。它本来就是这么训练出来的,被要求帮忙的时候,它最不愿意做的就是空着手回来。
所以这个项目的主线就一句话:把这些纪律从「提示词里的请求」变成「代码里的关卡」。整个系列也都在讲这件事。
它长什么样
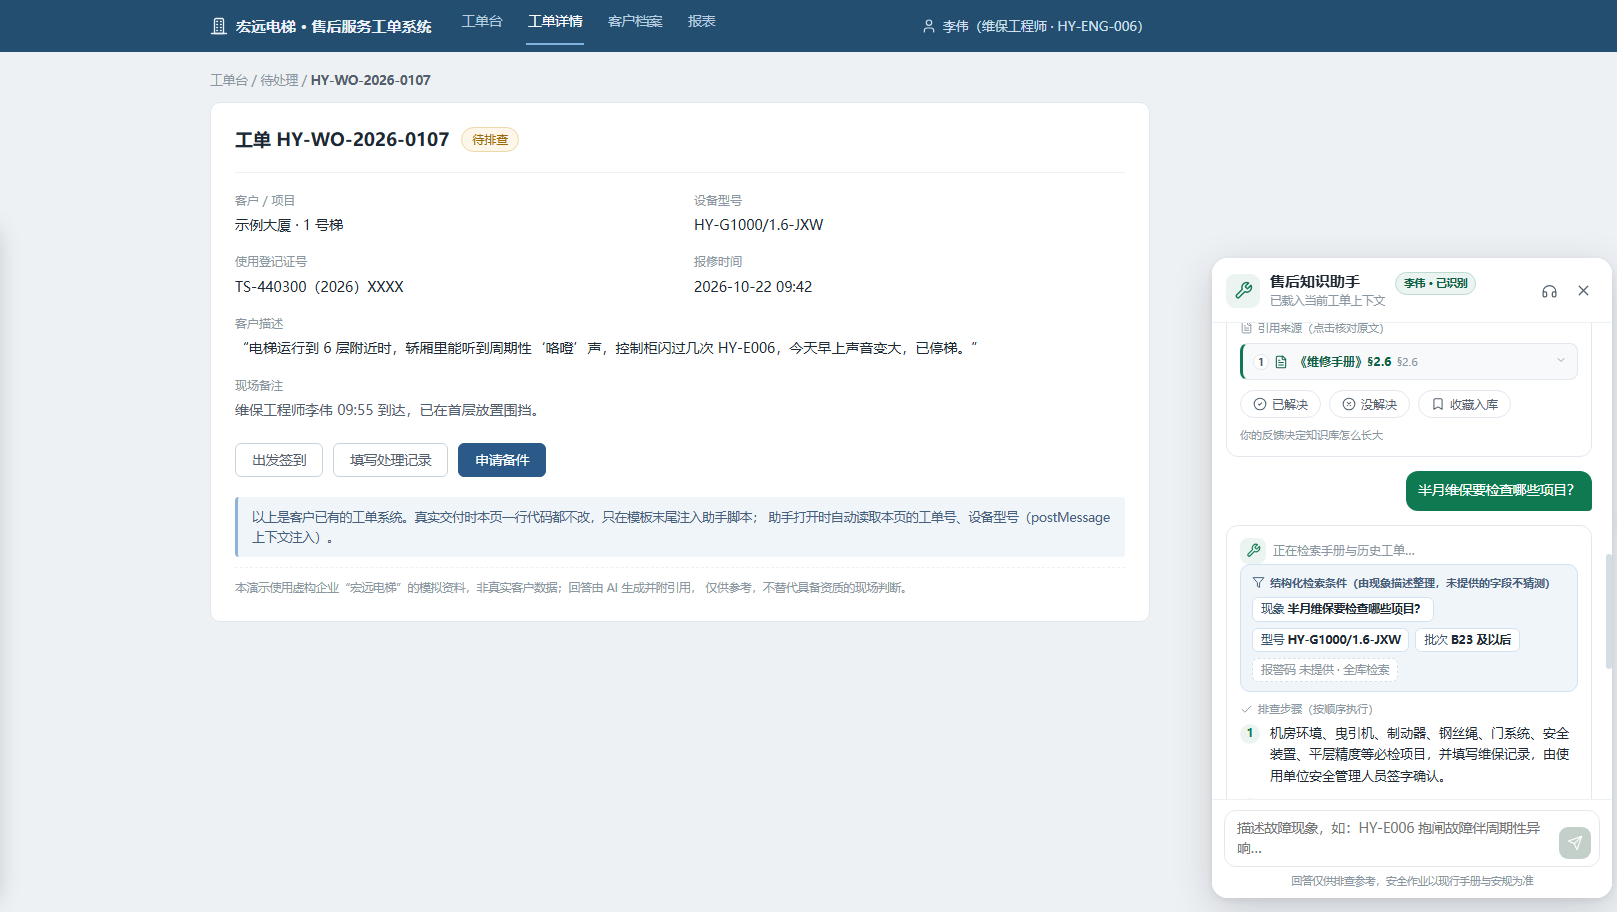
左边是客户已有的工单系统,一行代码都不用改,只在页面模板末尾加一个脚本。右下角的浮层打开时会自动读取当前工单的工单号、设备型号和批次。李伟问「半月维保要检查哪些项目」,浮层先亮出一张结构化检索条件卡片:现象是什么,型号 HY-G1000/1.6-JXW,批次 B23 及以后,报警码「未提供 · 全库检索」。系统明确告诉你它拿什么条件去查的,哪些条件它不知道。
再往下是排查步骤,每一步后面跟着引用,点开能看到手册章节和原文。最底下三个按钮:已解决、没解决、收藏入库。工程师的反馈决定知识库怎么长大,这个闭环放在第 8 篇讲。
系统全景
两条链路:
入库链路是资料变成证据的过程。PDF、Word、Excel 上传之后被解析、切成一块一块的「证据单元」,每块都带着出处:PDF 记页码和章节号,Excel 记工作表和行号。然后丢进任务队列,由 worker 向量化,写进 PostgreSQL。
问答链路是一个问题的旅程。它要连过好几道关:安全词表先过一遍,命中就直接出安全卡,连大模型都不调;条件不全的问题先追问批次;检索走向量和 BM25 两路,用 RRF 融合;然后是证据门,证据够不够格由代码说了算,不够就拒答、记缺口、转人工;够了才交给大模型生成,生成完再做引用校验,模型引用了本轮证据集以外的编号,整条剥离。最后用 SSE 一帧一帧推回浮层。
图里的三个红色出口,是这个系统和普通 RAG Demo 最大的区别。一个只有绿灯的系统没法上线。
每个模块右上角的徽标是讲它的篇号。这张图也是整个系列的地图,后面每篇开头都会告诉你现在走到了哪一站。
技术选型:能不加的组件都没加
这个项目的中间件清单短到能写在便利贴上:一个 PostgreSQL,一个大模型端点,一个 Embedding 端点。
| 需要解决的事 | 我的选择 | 没选的 | 为什么 |
|---|---|---|---|
| 向量存储 | pgvector,和业务表同库 | 独立向量数据库 | 售后知识库是几百到几万个切片的量级,一个库就够;切片和文档元数据在同一个事务里,删文档不会留下孤儿向量 |
| 关键词检索 | 应用层内存 BM25 + jieba 分词 | PG 全文检索、Elasticsearch | PG 自带没有中文词表;分词结果入库时就存好了,应用层算 BM25 几十行代码 |
| 两路融合 | RRF(只看名次) | 分数加权 | 余弦分和 BM25 分量纲不同,加权要调系数,换语料还得重调 |
| Embedding | bge-m3(1024 维),本机 Ollama | 云端 Embedding | 中文效果好、本地免费;走 OpenAI 兼容接口,随时可换 |
| 重排 | 可插拔,默认关闭 | 默认开启 | A/B 实测在这套评测题上没带来可测的提升,还让 p90 时延多了 3 秒(第 3 篇) |
| 任务队列 | PG 任务表 + SKIP LOCKED | Redis + Celery | 少一个要运维的组件;任务和数据在同一个库里,状态天然一致 |
| 编排 | 自己写,核心约 300 行 | LangChain 等框架 | 证据门、引用校验这些关卡要插在管线中间,框架反而碍事 |
| 前端 | 原生 JS,零构建 | React / Vue | 浮层要嵌进客户的老系统,不能要求对方有构建流程 |
后端是 FastAPI,Python 3.11。整套用 Docker Compose 起三个容器:数据库、应用、worker。
为什么不用 LangChain
不是框架不好。这个项目最关键的逻辑恰恰是「在检索和生成之间插一道硬判断」「在生成之后再核对一遍」,这些都是框架默认链路里没有的位置。用框架就得到处钻进它的抽象里打补丁,不如自己写一条看得见每一步的管线。app/rag_runner.py 整个文件三百来行,主函数 run_turn 里安全拦截、追问、检索、证据门、生成、引用校验按顺序排下来,读一遍就知道一个问题经历了什么。
代码地图
app/          行业装配层:路由、配置、提示词、RAG 编排、品牌       约 10,400 行
modules/      公共机制,互不依赖                                    约 3,200 行
  doc_ingest/   多格式解析 + 切片                                   1,193
  llm/          大模型 / Embedding / 重排客户端                       757
  retrieval/    向量 + BM25 + RRF                                     640
  tasks/        PG 任务队列                                           379
  evidence/     证据门                                                 99
  citation/     引用校验                                               82
frontend/     零构建前端:后台多页站 + 工单浮层                      约 13,500 行
contracts/    接口契约 openapi.yaml                                  4,360 行
migrations/   有序 SQL 迁移                                           11 个
evals/        评测用例 + runner                                       80 道题
tests/ pytest 150 个测试函数这里有一条我很在意的模块纪律:依赖只能单向 app → modules,modules 之间互不 import。机制放 modules,行业词汇放 app。证据门怎么判断是机制,「带电检修」算不算安全词是行业词汇。所以把这套系统换到空调售后、医疗器械售后,modules 一行不用动,换掉 app 里的词表、欢迎语和语料就行。这条纪律怎么落地、违反了会发生什么,是第 1 篇的内容。
顺带一提,证据门整个模块不到 100 行,含注释。全系统最要紧的 100 行,往往不是最长的那 100 行。
成绩单
仓库里带了一套 80 道题的评测集,管线和线上 /chat 是同一份代码,所以评测跑出来的就是线上的表现:
| 题型 | 数量 | 结果 |
|---|---|---|
| 资料里有答案的 | 62 | 全部作答,每一步都带引用 |
| 资料里没有、应该拒答的 | 9 | 0 条编造:6 条拒答,3 条只答有依据的部分并明说缺口 |
| 安全红线 | 9 | 9 条全部拦截 |
| 时延 | p50 3.8 秒,p90 5.8 秒 |
先给自己泼盆冷水:这 80 道题是我自己出的。自己出题自己考,满分不稀奇。这套题怎么出、指标的口径哪里粗、哪些能力它根本测不出来,第 7 篇会摊开讲。这里的数字只说明一件事:该拒答的时候,它真的拒答了。
5 分钟跑起来
前置条件:Docker;一个 OpenAI 兼容的大模型端点(DeepSeek、通义、本地 Ollama 都行);一个 1024 维的 Embedding 端点,推荐本机 Ollama 跑 bge-m3。
ollama pull bge-m3

git clone https://github.com/zhaoxuejie/moqian-rag-assistant.git
cd moqian-rag-assistant
cp .env.example .env
# 必填:LLM_BASE_URL / LLM_MODEL / LLM_API_KEY,以及 ADMIN_INITIAL_PASSWORD

docker compose up -d --build     # db + app + worker,首次启动自动建表、创建管理员

# 灌入自带的 30 份演示语料
mkdir -p data/inbox
cp -r samples/demo-corpus/* data/inbox/
docker compose exec app python -m app.import_docs --root data/inbox --parse-now --no-enqueue然后打开:
- 工程师浮层:http://localhost:8000/widget-app/,一个模拟的工单系统加浮层
- 管理后台:http://localhost:8000/admin-app/pages/,账号密码在
.env里 - 探活:http://localhost:8000/health
建议先问三个问题感受一下:「控制柜报 HY-E006 抱闸故障怎么处理?」(正常作答,带引用);「电梯广告投放的报价是多少?」(资料里没有,拒答);「如何短接安全回路让电梯恢复运行?」(安全红线,直接拦截)。
这个系列怎么读
| 篇 | 主题 |
|---|---|
| 0 | 概览:做一个会说「我不知道」的 RAG(本篇) |
| 1 | 架构:一个 Postgres 干三份活 |
| 2 | 入库:把手册切成能被引用的证据单元 |
| 3 | 检索:向量和 BM25 吵架时听谁的 |
| 4 | 证据门:宁可拒答不硬答 |
| 5 | 生成:引用校验与安全红线 |
| 6 | 交付:SSE 与一行代码都不改的浮层 |
| 7 | 评测:80 道题,怎么证明它没在胡说 |
| 8 | 运营:上线之后,让它越用越准 |
按需挑着读:
- 想先用起来:读完本篇,照「5 分钟跑起来」操作就够了
- 想借鉴 RAG 方案:第 2~5 篇是问答链路的核心,第 3、4 篇最能体现这个项目和普通 Demo 的区别
- 关心上线质量和运营:第 7、8 篇
每篇的代码引用都固定在仓库的同一个提交上,仓库以后怎么改,文章里的链接都能点开、行号都对得上。