
售后知识助手(二):把手册切成能被引用的证据单元
老陈带新人,最烦听到一句话:「手册上写了。」
哪本手册?哪一版?第几页?说不上来的「手册上写了」,在老陈那里等于没说。售后这一行,参数记错一位小数就可能出事,引用必须精确到能翻开就找到的地步。
助手也一样。它说「依据《维修手册》§2.6」,工程师点开,看到的必须正好是那一节;它说「P12」,翻到第 12 页就得有那段话。引用指错地方,比不引用还糟:不引用,工程师至少知道要自己去核对;引用错了,他会以为已经核对过了。
这一篇讲资料怎么变成「能被精确引用」的东西。
你在这里
上传原件 → 解析与切片 → 任务队列 → PostgreSQL(入库链路),问答链路的检索就从这里取数据
一、原子是切片,不是文件
普通的文档管理系统,最小单位是文件。这个知识库的最小单位是证据单元:一段能单独被引用、单独被核对的文本。一页手册可能切成两三块,一张 Excel 的每一行都是一块。
后台的知识源管理页把这件事写在了标题旁边,「知识库的原子是证据单元,不是文件」:
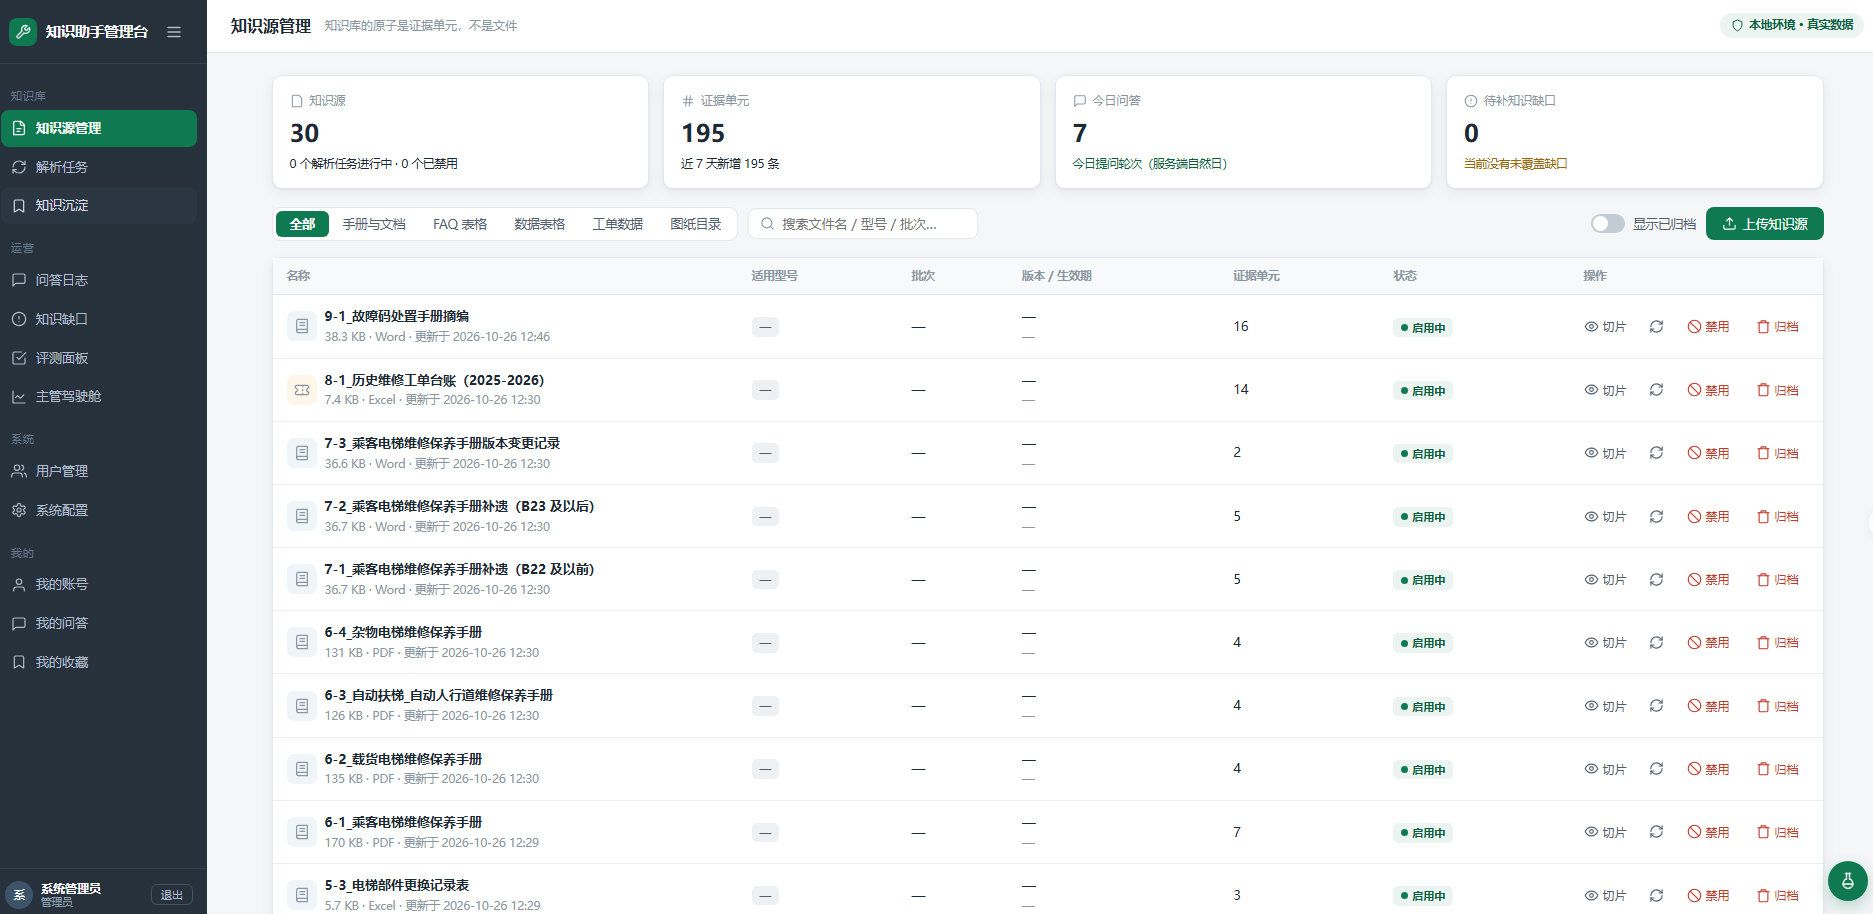
30 份演示资料,切出来 195 个证据单元。每个证据单元有一个全局唯一的编号:
def evidence_id_for(source_type: str, document_id: int, seq: int) -> str:
    """证据 ID:`M01001` = 手册 + 文档 01 + 第 001 片。"""
    prefix = EVIDENCE_ID_PREFIX.get(source_type, DEFAULT_EVIDENCE_PREFIX)
return f"{prefix}{document_id:02d}{seq:03d}"前缀按资料分类走:手册 M、工单 T、FAQ F、图纸 D、表格 X。这张前缀表放在 app/domain.py,因为「工单」「图纸」是售后行业的词汇,解析模块本身不认识它们。
为什么不用 UUID?因为这个编号是要给人看的。它会出现在大模型的回答里([M23002])、浮层的引用列表里、后台的问答日志里。工程师和主管看到 T08005,能一眼认出这是「工单类资料、第 8 份文档、第 5 条」。第 5 篇会讲,引用校验也正是靠这个格式从回答里把编号抽出来的。
二、出处随格式走
不同格式能提供的「出处」不一样,这个项目的原则是:有什么写什么,没有的不编。
| 格式 | 出处 | 页码 |
|---|---|---|
章节号 + 页码,如 §2.6 · P12 | 逐段精确到页 | |
| Word / Markdown / TXT | 章节标题 | 一律为空 |
| Excel FAQ | 工作表 + 行号,如 FAQ 第 2 行 | 为空 |
| 通用表格(台账、记录表、CSV) | 工作表 + 行号 | 为空 |
Word 的页码为什么是空的?Word 文件里根本没有「页」这个概念,分页是打开它的软件现场排出来的,换个字体、换个纸张大小,页码就变了。按字数估一个页码当然可以,但那就是一个看起来很精确的假页码。解析器的注释写得很直白:
Word 的分页由渲染器决定,落库时不能凭字数估算,否则引用会指到不存在的页码。
宁可只给章节,也不给一个会把人带错地方的页码。
三、PDF:先信目录,再清噪声
PDF 是售后资料里最常见的格式,也是最麻烦的。
章节:优先用书签目录
很多手册 PDF 自带书签目录(TOC),它就是「章节 → 页码」的权威映射,比从字体大小猜标题可靠得多。解析器优先用它。
没有目录的 PDF 才走兜底:用正则识别几种明显的标题形态,「第一章」「第二节」「2.6 抱闸故障」「附录 A」。注释里有一句我很认同的话:宁可漏认也不误认。漏认一个标题,最多是一整页变成一个块,引用粒度粗一点;误认一个标题,正文就被切进了错误的章节,引用会指错。编号标题还多了一条限制,数字后面必须紧跟中文,否则「24 小时服务热线」也会被当成第 24 章。
三类噪声
PDF 抽出来的文本里混着三类东西,不清掉会直接污染出处:
- 页眉页脚:书名、文件编号、版本号,每页都有。不清掉的话,每个切片里都混着一行「××维修保养手册 · 文件编号 · 版本号」之类的文字,向量检索会被它严重干扰。
- 目录行:「2.6 抱闸故障 ………… 12」。看着像标题,其实不是正文,绝不能当成章节。
- 页码、热线、网址:不承载知识,还会干扰标题识别。
页眉页脚的识别靠「跨页频率」:
def _boilerplate_lines(page_lines: list[list[str]]) -> set[str]:
    """跨页重复出现的短行 = 页眉/页脚,返回其"签名"集合。"""
    if len(page_lines) < 2:
        return set()
    threshold = max(2, math.ceil(len(page_lines) * 0.5))
    ...
    return {
        key
        for key, count in counts.items()
        # 标题样式的行不参与"页眉"判定:它可能既是真标题、又是续页页眉
        if count >= threshold and 4 <= len(key) <= 80 and key not in heading_sigs
}modules/doc_ingest/pdf.py#L78-L100
一行短文本在一半以上的页面都出现过,就判定为页眉页脚。比较之前先把行尾的页码去掉,「文件编号… 版本:3 1」和「… 2」才会被认成同一行。
踩坑:标题也会「跨页重复」
有些手册在每一页顶部重复当前章节的标题(续页页眉)。按频率规则,它会被当成页眉删掉,真正的章节标题也就跟着没了。所以长得像标题的行不参与页眉判定,续页上的重复标题交给章节切分那一步,按「和上一节同名就跳过」来处理。
页码要逐段归属
一个章节可能横跨好几页。最省事的做法是整节共用一个页码范围「P12–P14」,但一个切片如果只包含第 13 页的内容,引用写「P12–P14」就让人白翻了两页。
所以解析结果里每个章节都保留了「每一页各自的文本」,切片时逐段标注所在页码,一个切片的页码范围就是它实际包含的那几页。
扫描件直接拒收
有些 PDF 是扫描件,整份都是图片,一个字也抽不出来。判断很粗暴:可提取的汉字数少于 max(20, 页数 × 5),就判定为疑似扫描件,入库失败,提示「需要 OCR 后再入库」。不做 OCR 是有意的:OCR 的识别错误会变成「带引用的错误参数」,这比没有这份资料更危险。
四、切片:不跨章节,不糊页码
解析之后是切片。切片器开头的注释列了三条约束:
- 原子是切片,不是文件:每块都要能单独作为证据被引用
- 出处随格式走:PDF 的每块必须带准确页码
- 不做无依据的合并:小块宁可单独成块,也不和别的章节拼在一起
具体规则:每块上限 700 字、下限 120 字;段落优先,一段太长就按句号切,句子还太长就硬切(中文没有空格,没法按词切);每块正文以章节标题开头,这样检索命中时,模型能看到「这段话出自哪一节」。
最关键的是第三条,体现在合并小块的逻辑里:
def _merge_small(drafts: list[ChunkDraft], *, min_chars: int) -> list[ChunkDraft]:
    """把过短的块并回**同一章节**的前一块;跨章节不合并(合并会让引用指错节)。"""
    merged: list[ChunkDraft] = []
    for draft in drafts:
        if (
            merged
            and len(draft.text) < min_chars
            and merged[-1].section_no == draft.section_no
            and merged[-1].heading == draft.heading
            and len(merged[-1].text) + len(draft.text) <= min_chars * 3
        ):
            previous = merged[-1]
            previous.text = previous.text + "\n" + draft.text
            previous.page_from = min(previous.page_from, draft.page_from)
            previous.page_to = max(previous.page_to, draft.page_to)
            continue
        merged.append(draft)
...modules/doc_ingest/chunker.py#L147-L167
很多 RAG 教程会把短块往前后拼,凑够长度再说。对一般问答这没问题,但在这里,§2.6 末尾的一小段和 §2.7 开头拼在一起,这个切片该标哪一节?标哪一节都有一半是错的。所以短块只能并回同一章节的前一块,跨章节宁可留一个短块。
切片粒度没有标准答案
700 / 120 这组数是在这批演示语料上调出来的,后台和 .env 都能改。判断粒度合不合适,我用的是一个很土的办法:随机抽十个切片,问自己「如果只给我看这一块,我能不能判断它在说什么、出自哪里」。能,粒度就差不多;不能,要么太碎,要么混了太多东西。
五、表格:每一行都是一条证据
售后资料里有大量表格:FAQ、工单台账、维保记录表、部件更换记录。表格不按字数切,一行一条证据。
FAQ 最简单,一行就是一个「问题 + 答案」,本身就是完整的证据。通用表格麻烦一点:一行数据单独拿出来是「HY-G1000 | B23 | 0.20 | 0.40」,模型完全看不懂这几个数是什么。所以每一行都渲染成「列名:值」的形式,大致是这样(示意):
型号:HY-G1000/1.6-JXW
批次:B23 及以后
间隙下限(mm):0.20
间隙上限(mm):0.40表头是语义的一部分,丢了表头,数字就没有意义。
找表头本身也有讲究。很多 Excel 第一行是合并单元格的大标题(「宏远电梯部件更换记录表」),只有第一格有值,不能当表头。规则是:前 10 行里,第一行有两个以上非空单元格的才是表头;表头之前的标题和说明文字,单独存成一条「前言」证据,也不丢。
还有两个细节:
- 行级批次。FAQ 表里可以有一列「适用批次」,填了值的行,批次以行为准;没填的行继承整份文档的批次;两者都空就是「不限批次」。这一列叫什么名字(「适用批次」「批次」「batch」)由 app 注入,解析器不认识行业词。
- 行数上限。一张表超过 5000 行直接拒收,提示拆分。表格入库会产生大量切片,不能无限吃。
六、流水线:幂等、可重跑、失败要说清楚
一份文件从上传到可检索,经过这几步:
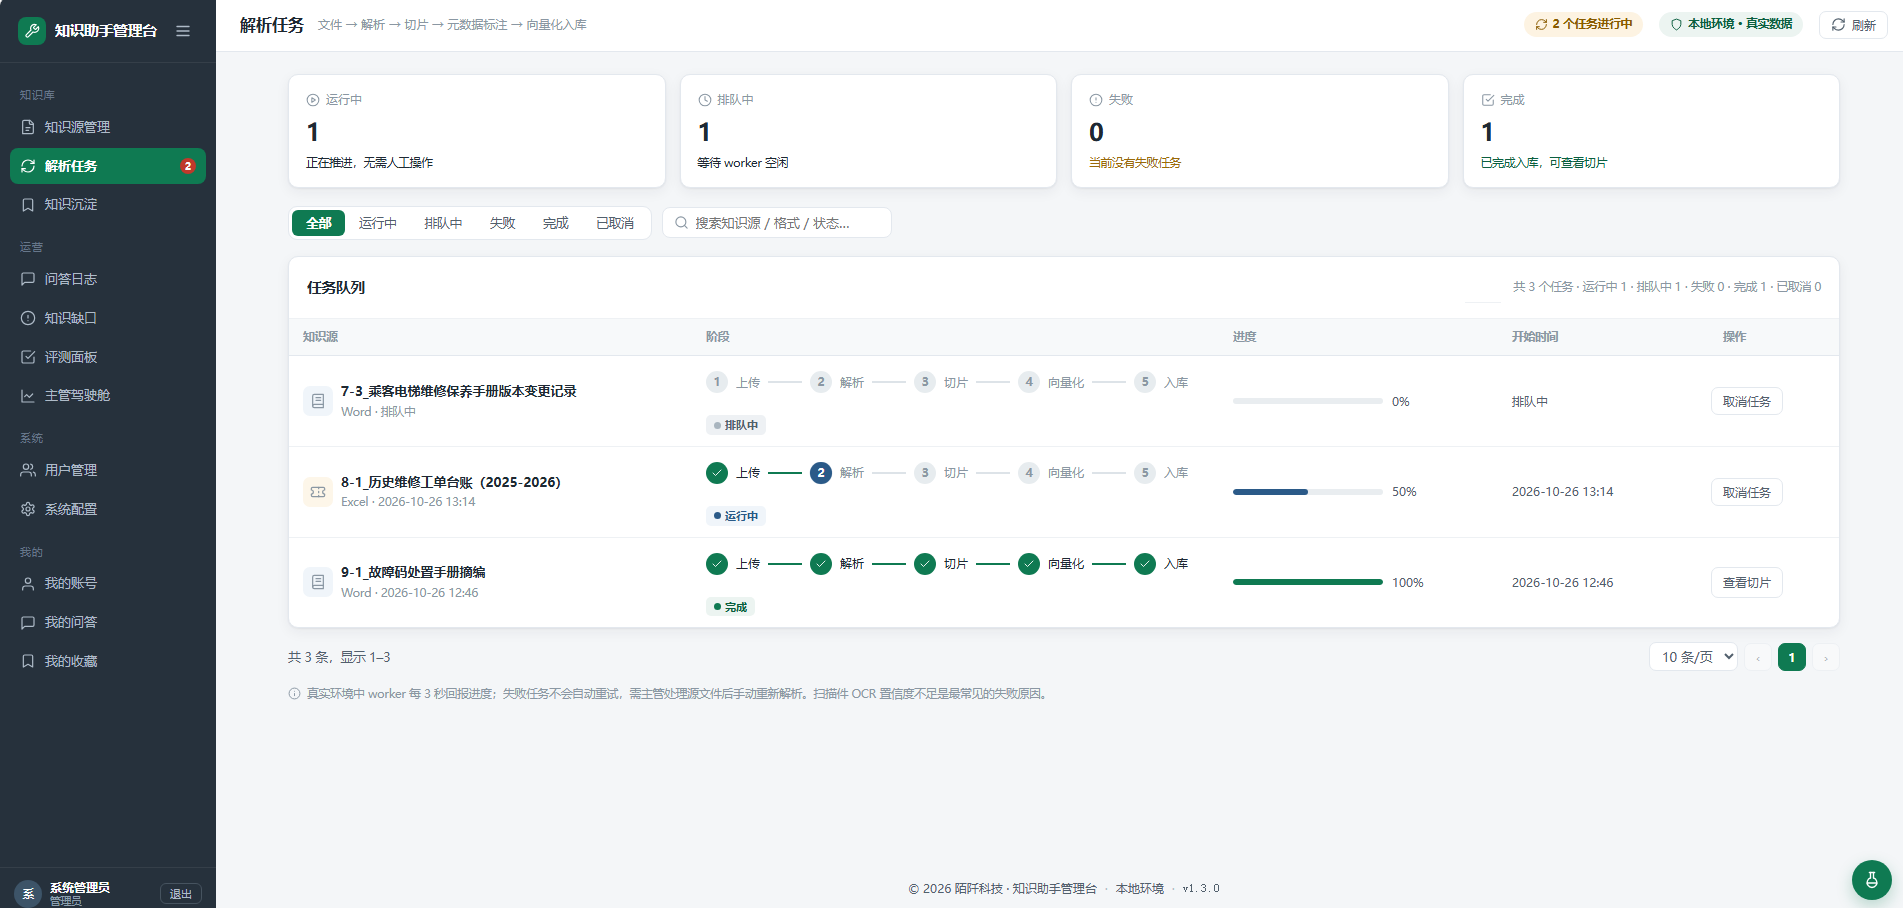
建档时按 sha256 去重。同一份文件上传两次,只会建一份档案。批量导入用的是一个命令行脚本,而不是启动时自动扫目录:
自动扫描会在启动时意外把新文件入库,「入库」是治理动作,应由人触发。
原件统一复制进 data/original-docs/,后台的「原件在线预览」只允许读这个目录。
解析失败要说人话。疑似扫描件、解析成功但一个有效切片都没有、向量条数和切片数对不上,每种失败都会把具体原因写回文档状态,后台能直接看到「为什么失败」,而不是一个笼统的「解析出错」。
向量化走 OpenAI 兼容接口,默认是本机 Ollama 跑 bge-m3。仓库里记了一组实测数据:单条冷启动约 9.2 秒(加载模型),批量 8 条约 754 毫秒。所以向量化一定要分批,默认每批 16 条。返回的维度如果和库表的 vector(1024) 对不上,抛的是配置错误,不重试,因为重试一万次也还是错的维度。
落库是先删后建,在一个事务里:
# 入库事务:先删旧切片再整体写入,保证重复解析不翻倍
with conn.cursor() as cur:
    cur.execute("delete from chunks where document_id = %s", (doc_id,))
    for draft, vector in zip(drafts, vectors, strict=True):
        # 行级批次优先;行内没填则继承文档批次(两者都空 = 不限批次)
        chunk_batch = draft.batch or batch
        ...
        cur.execute("insert into chunks (...) values (...)", (
            doc_id,
            evidence_id_for(category, doc_id, draft.seq),
            draft.text,
            ...
            _vector_literal(vector),
            _tokenize(draft.text),     # jieba 预分词,BM25 直接用
))同一份文档解析多少遍,结果都一样,不会翻倍。改了切片参数想重新切,点一下「重新解析」就行。BM25 要用的分词结果也在这一步顺手算好存起来,第 3 篇的内存 BM25 索引就是直接读这一列。
zip(..., strict=True) 是一个小保险:向量和切片条数不一致时,宁可在这里报错,也不能让第 5 条切片配上第 6 条的向量。前面已经单独检查过一次条数,这里是第二道。
七、小结
| 原则 | 落在哪 |
|---|---|
| 知识库的原子是证据单元 | 每块有人能读懂的全局编号 M01001 |
| 出处随格式走,不编页码 | Word / 表格页码为空;PDF 逐段归属页码 |
| 宁可漏认,不误认 | 标题识别只认明显形态;扫描件直接拒收 |
| 不跨章节合并 | 短块只并回同一章节的前一块 |
| 表头是语义的一部分 | 表格每行渲染成「列名:值」 |
| 入库是治理动作 | 人工触发导入;sha256 去重;先删后建保证幂等 |
资料变成了一块块带编号、带出处的证据,存进了 PostgreSQL。接下来它们怎么被找出来,是第 3 篇的内容;找出来之后够不够格回答,是第 4 篇。