
售后知识助手(三):向量和 BM25 吵架时听谁的
老陈带新人有句口头禅:「先看铭牌,再翻书。」同一个型号的电梯,B22 批次和 B23 批次用的制动器都不一样,书翻得再快,翻错了批次也是白翻。
检索就是系统替工程师「翻书」的那一步。这一篇讲它怎么翻:两路召回怎么合并,怎么只翻对应批次的那几页,以及我为什么测完重排又把它关了。
你在这里
浮层提问 → 安全红线 → 结构化条件 → 混合检索 → 证据门 → 生成与引用校验 → SSE 返回
本篇的代码都在 modules/retrieval/,一共 640 行。下文的源码链接固定在仓库提交 df3d9c5。
一、一路召回为什么不够
向量检索擅长的是「意思差不多」。工程师说「轿厢一顿一顿的」,手册里写的是「运行中有周期性冲击」,字面上几乎没有重合,向量能把它们拉到一起。
但售后问题里有大量必须字面精确的东西:故障码 HY-E006、批次 B23、间隙 0.30 mm、工单号 HY-WO-2026-0021。在 Embedding 眼里,HY-E006 和 HY-E013 很可能都只是「一个故障码」,向量离得很近;可在工程师眼里,一个是抱闸故障,一个是平层感应器故障,处置完全两回事。
BM25 正好反过来:它只认字面,故障码一个字符都不会认错,但听不懂口语改写。
真实的提问往往两样都占。「控制柜报 HY-E006 抱闸故障怎么处理」,前半句要精确匹配,后半句要语义理解。所以两路都要,问题只剩一个:两路给出的排名不一样时,听谁的?
二、BM25 为什么在应用层自己算
先说 BM25 这一路。按常理,数据已经在 PostgreSQL 里,用 PG 的全文检索最省事。问题是 PG 自带的全文检索没有中文词表,「制动器间隙」会被当成一整个词或者拆成单字,都不对。上 zhparser 之类的中文分词扩展可以解决,但这意味着要自己编译扩展,pgvector/pgvector:pg16 这个官方镜像就不能直接用了。
我的做法是:分词在入库时就做完。切片入库时用 jieba 的搜索引擎模式分好词,存进 chunks.bm25_tokens 这一列;查询时在应用层把语料加载成内存索引,用标准 BM25 公式(k1=1.5,b=0.75)算分。核心循环就这么几行:
for doc in self._docs:
    score = 0.0
    for token in tokens:
        tf = doc.tokens.get(token)
        if not tf:
            continue
        denominator = tf + K1 * (1 - B + B * doc.length / (self.avgdl or 1))
        score += self._idf[token] * tf * (K1 + 1) / denominator
    if score > 0:
scored.append((score, doc.chunk))modules/retrieval/bm25.py#L52-L67
全量遍历,没有倒排索引,听起来很土。但售后知识库的量级是几百到几万个切片,每次查询扫一遍完全够快,换来的是零额外组件。等哪天语料涨到几十万切片,再换 Elasticsearch 也不迟,到时候只换这一个文件。
索引不能每问一次就重建。Bm25IndexCache 给语料算一个「签名」,签名没变就复用内存里的索引。签名最早只有两项:切片总数和最大切片 id。后来发现一个漏洞:管理员在后台停用一份文档,切片一条没删,总数和最大 id 都不变,索引就一直不重建,已经停用的手册还在被检索。现在签名多了第三项,文档表的最后更新时间:
select count(*), coalesce(max(c.id), 0), coalesce(max(d.updated_at)::text, '')
  from chunks c join documents d on d.id = c.document_id
where c.disabled = false and d.lifecycle not in ('disabled', 'archived')踩坑:缓存签名要覆盖「不增删数据的变更」
用「数量 + 最大 id」判断数据有没有变,只能感知增删,感知不到状态变化。停用、归档、改元数据,这些都是不动行数的变更。缓存失效的条件,要按「哪些变化会影响结果」来列,而不是按「哪些变化容易检测」来列。
三、RRF:只看名次,不看分数
两路召回各给出 20 条候选,现在要合成一个排名。
最直觉的做法是分数加权:0.7 × 向量分 + 0.3 × BM25 分。麻烦在于两种分数不是一个量纲。余弦相似度落在 0 到 1 之间,而且实际分布很挤,相关和不相关可能只差零点几;BM25 分数没有上界,几分到十几分都常见,还随语料规模和查询长度变化。系数今天调好了,明天多导入一批工单就得重调。
RRF(Reciprocal Rank Fusion,倒数排名融合)干脆不看分数,只看名次:
k 取 60,是这个算法的常用值。拿一组示例数字算一遍就明白它的性格:
| 切片 | 向量排名 | BM25 排名 | RRF 分 |
|---|---|---|---|
| B | 4 | 2 | 1/64 + 1/62 = 0.0318 |
| D | 2 | 9 | 1/62 + 1/69 = 0.0306 |
| A | 1 | 未命中 | 1/61 = 0.0164 |
| C | 未命中 | 1 | 1/61 = 0.0164 |
两路都召回的切片,哪怕在每一路里都不是第一,也会排到只在一路里拿第一的切片前面。RRF 奖励的是「共识」:两种完全不同的检索方法都觉得它相关,那它大概率是真相关。
实现也很短。合并时保留两路的原始分数,并记下这条切片是从哪一路来的:
def absorb(items: list[ScoredChunk], source: str) -> None:
    for rank, item in enumerate(items, start=1):
        scores[item.chunk_id] = scores.get(item.chunk_id, 0.0) + 1.0 / (k + rank)
        existing = merged.get(item.chunk_id)
        if existing is None:
            item.sources = sorted({*item.sources, source})
            merged[item.chunk_id] = item
            continue
        # 同一块被两路命中:合并不重复的字段,标 both
        existing.sources = sorted({*existing.sources, source})
        ...

absorb(dense, "dense")
absorb(bm25, "bm25")modules/retrieval/fusion.py#L18-L64
sources 字段(dense / bm25 / both)会一路带到后台的问答日志里。哪天有人问「这条证据怎么排进来的」,翻日志就知道是向量捞的、关键词捞的,还是两路都捞到了。调参的时候,这个字段比任何直觉都管用。
四、一个被模板挤掉的「钢丝绳」
RRF 奖励共识,这个性格也会坑人。
评测集里有一道题:「钢丝绳在维保时怎么检查?」资料里明明有答案,检索结果里却找不到。排查下来,元凶是模板。演示语料里的多份手册共用同一套模板,「维护周期」那一段文字一模一样,在库里以 8 到 15 个内容完全相同的切片存在。
这些切片和问题里的「检查」「维保」「需要」都沾边,向量和 BM25 两路都把它们排得很靠前,RRF 一融合,前 8 名几乎被它们占满。真正讲钢丝绳检查的那个切片,BM25 排第一,但向量那一路没把它排进前列,只拿到单路的分数,被挤出了证据集。
最后修了三处:
- 查询侧去虚词。「怎么」「如何」「需要」「哪些」这类词参与 BM25 只会把模板切片往上顶,查询分词时直接滤掉,BM25 才能聚焦到「钢丝绳」这种实词上。
- 截断前先按正文去重。完全相同的切片只留排名最高的那一条,把位置让给信息不重复的证据:
def dedupe_by_content(items: list[ScoredChunk], *, limit: int) -> list[ScoredChunk]:
    seen: set[str] = set()
    kept: list[ScoredChunk] = []
    for item in items:
        key = " ".join(item.content.split())
        if key in seen:
            continue
        seen.add(key)
        kept.append(item)
        if len(kept) >= limit:
            break
return kept- 证据集从 8 条放宽到 12 条。去重之后,只被单路命中的稀有词切片才有机会挤进来。12 是实测的折中:再多,提示词变长、生成变慢;再少,「钢丝绳」又会掉出去。
修完以后,这道题的证据集里能稳定找到讲断丝、磨损检查的切片,评测里正常作答。
踩坑:去重要在截断之前
如果先截断到 12 条再去重,12 条里 9 条是同一段模板,去重后只剩 4 条证据,问题反而更糟。顺序必须是「融合 → 去重 → 截断」。
五、批次路由:先看铭牌,再翻书
回到开头老陈那句话。概览篇讲过,同一个「制动器间隙标准是多少」,B22 批次是 0.30~0.50 mm,B23 批次是 0.20~0.40 mm。检索要做的,是只翻对应批次的那几页。
条件从哪来:不猜
型号和批次只有两个来源:浮层从工单页读到的上下文,或者工程师自己确认的选择。系统从不从问题文本里猜批次。猜对了省一步,猜错了就是拿 B23 的标准去调 B22 的抱闸,这笔账怎么算都不划算。
有型号、没批次,而且问题属于批次敏感类(平层、门刀、间隙、编码器、自学习),库里又确实存在多个批次的资料,系统会先追问一轮:B22 及以前、B23 及以后,或者「不确定,并列展示」。只追问一轮,再问工程师就要骂人了。
这里有个小插曲。最早「平层」是敏感词,结果「HY-E013 平层感应器故障怎么处理」也被拦下来追问批次。可故障码摘编里每个故障码的处置步骤本来就按批次写明了参数,这一问纯属多余。现在问题里带故障码就跳过追问。
过滤怎么做:空值等于通用
向量那一路在 SQL 里直接过滤:
if batch:
where.append("(c.batch is null or c.batch = %s)")注意 is null。批次为空的切片表示不限批次,比如通用的安全规程、联系电话,任何批次都适用,不能被过滤掉。型号同理,还支持「BK / BK系列」这种等价写法的集合匹配,但只做等值匹配,不做模糊匹配。
过滤后不够怎么办:宁缺勿滥
过滤后的结果分三种情况,每种都会在浮层的「结构化检索条件」卡片上留一句说明:
中间那个分支是故意的。精确匹配只有两条时,最省事的做法是「不够就回退全库」,但那样会把两条精确证据淹没在一堆其他批次的结果里。少而准的证据,比多而杂的证据有用。系统把「样本量不足」明确告诉工程师,由人来判断。
融合之后再筛一遍
这是整篇里最隐蔽的一个坑。向量那一路在 SQL 里按批次过滤了,可 BM25 是内存索引,不支持过滤。于是 B22 批次的切片会从 BM25 那条路溜进来,RRF 一融合,B23 的问题引用了 B22 的参数。
修法是在融合之后按出处再筛一遍,口径和 SQL 保持一致,空值仍然算通用:
def _provenance_ok(item) -> bool:
    if batch and item.batch not in (None, batch):
        return False
    if model and item.model not in allowed_models and item.model not in (None, ""):
        return False
    return True

fused = [item for item in fused if _provenance_ok(item)]modules/retrieval/pipeline.py#L108-L122
踩坑:两路召回的过滤口径必须一致
混合检索里只要有一路不支持过滤,过滤就不能只放在那一路的查询里。要么两路都能过滤,要么在融合之后统一过滤。否则「过滤」只是降低了串批次的概率,而不是杜绝。
评测集里专门有一对题:同一句「制动器间隙标准是多少」,分别带 B22 和 B23 的工单上下文。两道都通过了,证据集里命中的分别是 0.30~0.50 和 0.20~0.40 那两份补遗。
六、重排:测了,关了
重排(rerank)是在融合之后再加一层 cross-encoder 精排:把问题和每个候选切片成对送进模型打分,比向量检索更细。很多 RAG 教程把它当标配。
我先试的是本机 Ollama 跑 bge-reranker,结果要么加载就崩,要么分词结果是坏的。后来接了腾讯云 AI Search 的 /v1/rerank(同样是 bge-reranker-v2-m3),总算跑通,然后做了一次 A/B:同一套 29 道题,同一个大模型,只切换重排开关。
| 指标 | 只用 RRF | RRF + 重排 |
|---|---|---|
| 检索命中率 | 100% | 100% |
| 可回答题作答率 | 100% | 100% |
| 引用覆盖率 | 100% | 100% |
| 拒答判断准确率 | 100% | 100% |
| 时延 p50 | 5.1 秒 | 5.1 秒 |
| 时延 p90 | 17.2 秒 | 20.4 秒 |
(2026-10-19,报告在仓库 evals/reports/d15-ab-*.md。)
重排并不是没干活。在 18 道正常作答的题里,它改了一半题目的第一名,前三名完全一致的只剩 1 道。但这些变化没有反映到任何一个结果指标上,代价却是 p90 多了 3 秒。
我的理解是两个原因叠加:一是证据集 12 条是整体塞进提示词的,集合内部谁排第一,对大模型最终的回答影响有限;二是这套指标本身比较粗,「检索命中」只看关键词有没有出现在证据集里,排序上的细微改进它根本看不见。第二点是评测的问题,第 7 篇再细说。
结论是:默认关闭,但保留插口。
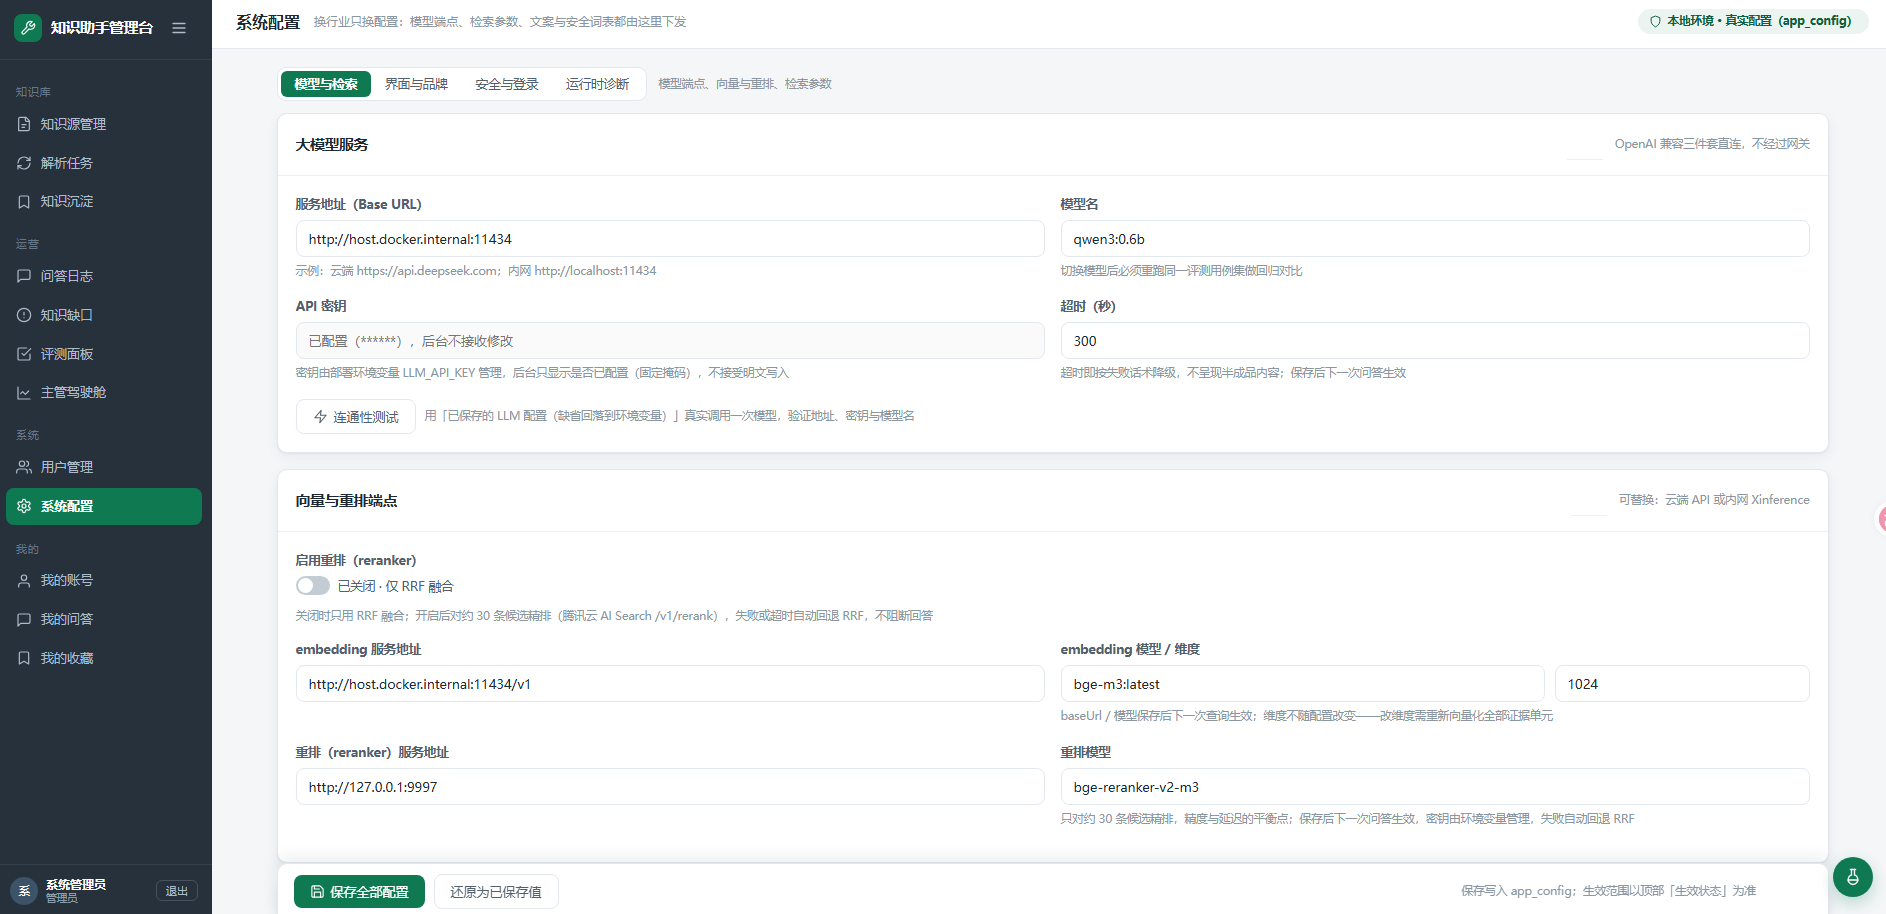
后台一个开关就能打开。打开之后,重排也只对融合结果的前 30 条做,而且任何失败都降级回 RRF,绝不阻断回答:
try:
    result = self.reranker.rerank(question, [item.content for item in candidates])
    scores = list(getattr(result, "scores", []) or [])
    if len(scores) == len(candidates):
        ...
    else:
        logger.warning("reranker returned %d scores for %d candidates; fallback RRF", ...)
except Exception as exc:  # noqa: BLE001 - 重排失败必须降级
logger.warning("rerank failed, fallback RRF: %s", exc)这里还校验了返回的分数条数和候选条数是否相等。腾讯云的接口按分数降序返回,但不保证包含所有文档,条数对不上就说明结果不完整,宁可不用。
为什么不「先开着再说」
多一个组件就多一个故障点、多一份账单、多一段时延。一个功能能不能留在默认链路里,看的是它在你自己的数据上能不能测出收益,而不是它在别人的教程里是不是标配。测不出来,就先关着,等评测集更细了再测一次。
七、小结
这一篇的检索参数,都可以在 .env 或后台配置里改:
| 参数 | 默认值 | 含义 |
|---|---|---|
RETRIEVAL_TOP_K_DENSE / _BM25 | 20 / 20 | 每路召回条数 |
RETRIEVAL_RRF_K | 60 | RRF 的 k |
RETRIEVAL_FINAL_TOP_N | 12 | 去重后进入证据集的条数 |
RETRIEVAL_MIN_FILTERED_HITS | 3 | 过滤后少于这个数,就标注「结果可能不完整」 |
RERANKER_PROVIDER | none | 重排开关 |
最后留个问题。检索有一个天生的毛病:它永远会返回点什么。你问它「量子计算机的退相干时间怎么测量」,它也会恭恭敬敬地递上 12 条电梯手册的切片,最高的向量相似度还有 0.45。
到这一步为止,系统还不知道自己该不该开口。下一篇讲的证据门,就是专门回答这个问题的。