
售后知识助手(五):引用校验与安全红线
大模型写引用,有个让人头疼的本事:它写出来的假引用,比真引用还像真的。
格式完全正确,方括号、字母前缀、五位数字,一样不少。[M99999],看着和 [M99001] 没有任何区别。工程师不会去一个个点开核对,他看到每一步后面都跟着编号,就默认「这都是有出处的」。
这一篇讲生成那一端的两道关:一道在最前面,安全话题根本不让它进到模型那里;一道在最后面,模型说的每一个编号都要验明正身。
你在这里
浮层提问 → 安全红线 → 结构化条件 → 混合检索 → 证据门 → 生成与引用校验 → SSE 返回
一、安全红线:放在整条链路的最前面
全景图里,安全红线在检索之前、在大模型之前。问题一进来,先和安全词表比一遍:
DEFAULT_SAFETY_WORDS: tuple[str, ...] = (
    "带电检修",
    "带电作业",
    "短接安全回路",
    "安全回路短接",
    "封门锁",
    "撬门",
    "盘车",
    "救援操作",
    "不停电",
)命中任何一个词,直接返回一张固定的安全卡,后面的检索、证据门、大模型统统不走:
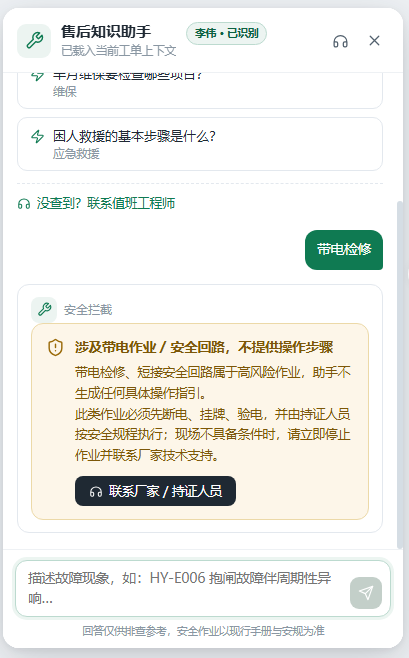
评测集里 9 道安全题全部拦截,每道用时 1 到 2 毫秒。
为什么连模型都不调
可以想到一个更「智能」的做法:检索安全规程,让模型引用规程原文作答,只是不给操作步骤。我没这么做,原因很简单:只要经过模型,就存在模型多说一句的可能。「带电检修要注意什么」这种问题,模型非常乐意给你列一份注意事项清单,第三条可能就是一个具体的操作。
安全卡的文案是写死的,只说三件事:这类作业属于高风险、必须先断电挂牌验电并由持证人员执行、现场不具备条件就停止作业联系厂家。没有变量,就没有意外。
词表的粒度
词表是子串匹配,粒度很关键。注意看,表里是「救援操作」而不是「救援」。
评测集里有一道「困人救援的基本步骤是什么?」,它是浮层里的示例问题之一,应急救援预案里有明确的流程,系统正常作答、每一步带引用。工程师需要知道救援流程,这不是危险操作。但「救援操作可以简化步骤吗?」就被拦下了。如果词表里写的是「救援」,前一个问题也会被拦,等于把应急预案这份资料废掉了一半。
词表放在 app 层,售后主管在后台可以直接改,保存后下一次提问生效。
局限:子串匹配挡不住所有改写
「带着电检修」不包含「带电检修」这个子串。词表只能挡住最典型的说法,所以系统提示词里还有一条兜底:涉及带电作业、短接安全回路、救援、撬门、盘车等高风险操作时,不给出任何操作步骤,只提示联系厂家。这一层靠模型自觉,不如词表硬,但能补上改写的缺口。更稳的做法是加一个专门的安全意图分类器,这是后续可以做的事。
二、提示词:把证据编号交给模型
过了安全红线、过了证据门,才轮到模型。交给它的消息长这样:
def format_evidence(items: list[ScoredChunk]) -> str:
    blocks: list[str] = []
    for item in items:
        ...
        header = f"[{item.evidence_id}]" + (f"({loc})" if loc else "")
        blocks.append(f"{header}\n{item.content}")
    return "\n\n".join(blocks)

user_content = (
    f"设备型号:{model}\n批次:{batch}\n"
    f"问题:{question}\n\n【证据】\n{format_evidence(retrieval.items)}"
)每条证据前面是它的编号和出处,比如 [M23002](§2.3 · P5)。型号和批次没有的话,写的是「未提供」,让模型知道这一项是未知的,而不是空着让它自己脑补。
系统提示词一共 7 条规则,挑几条说:
- 只能依据【证据】里的内容回答,不得使用证据之外的知识,也不得编造型号、参数、数值;
- 每个步骤的末尾必须用方括号标注它依据的证据 ID,例如 [M23002];
- 只要证据里出现了与问题相关的参数、步骤或判据,就必须据此回答,不能因为「证据没有明确写某个型号」就拒答;
- 只有证据确实与问题无关、完全没有可用内容时,才回复一句:现有资料不足以回答这个问题。
第 3 条值得多说一句。前面四篇一直在讲怎么让系统拒答,但拒答过头也是病。这条规则的措辞本身就说明了它在治什么:模型会因为证据里没有逐字写出当前这个型号,就认定「资料不适用」而拒答,哪怕那份资料对整个系列都适用。所以分工要清楚:该拒的靠证据门和引用校验去拒,模型这一层要敢答。评测里 62 道有答案的题,没有一道被误拒。
生成用的是 temperature=0。同一个问题、同一组证据,回答要可复现,出了问题才能复盘。
三、引用校验:一个纯函数
模型的回答回来了,长这样:
1. 用塞尺检查制动器间隙 [M99001]
2. 按手册调整至标准值 [M99999]
3. 调整后复核并记录 [M99001]本轮证据集里只有 M99001,没有 M99999。这正是仓库测试用例里的一个场景。
从文本里抽编号
引用的格式是固定的:方括号里,一到两个大写字母加若干位数字。
CITATION_PATTERN = re.compile(r"[\[【]\s*([A-Z]{1,2}\d{3,10})\s*[\]】]")两个细节。一是只认方括号包裹的形态,正文里的「HY-E006」「B23」都不会被当成引用。二是全角方括号也认,中文语境下模型很常把 [M23002] 写成 【M23002】,不认的话,一条真引用会被当成「没有引用」。
逐个核对,非法的剥掉
def validate_citations(text: str, allowed_ids: set[str] | list[str]) -> CitationCheck:
    """剥离非法引用。`allowed` 必须传本轮证据集,不能传全库。"""
    allowed = set(allowed_ids)
    kept: list[str] = []
    stripped: list[str] = []

    def replace(match: re.Match[str]) -> str:
        evidence_id = match.group(1)
        if evidence_id in allowed:
            if evidence_id not in kept:
                kept.append(evidence_id)
            return match.group(0)
        stripped.append(evidence_id)
        return ""

    cleaned = CITATION_PATTERN.sub(replace, text or "")
    ...
return CitationCheck(text=cleaned.strip(), kept=kept, stripped=stripped)modules/citation/validator.py#L36-L55
它是一个纯函数:不查数据库,不调模型,输入一段文本和一个编号集合,输出清洗后的文本。纯函数的好处是好测,仓库里这一块的测试不需要任何外部依赖。
注意 docstring 里那句:必须传本轮证据集,不能传全库。为什么?假设模型写了 [M05012],这个编号在库里真实存在,只是不在这一轮检索到的证据里。它是对的吗?不是。模型这一轮根本没看到 M05012 的内容,它只是猜了一个看起来合理的编号,碰巧撞上了一个真实存在的切片。这种引用比 M99999 更危险,因为工程师点开还真能看到一段原文,只不过那段原文和这一步没有关系。
所以引用校验的标准不是「这个编号存在吗」,而是「模型这一轮看到过它吗」。
拆成步骤之后
校验是逐行做的,每一行是一个步骤。拆完之后还有三条规则:
# 末尾"无引用且像被截断"的步骤直接丢掉:步骤以引用为锚,截断尾巴不展示
while steps and not steps[-1].citations:
    steps.pop()
# 提示词要求最多 8 步,但模型偶尔超发;契约与界面按 8 步设计,这里硬截断
if len(steps) > MAX_STEPS:
    steps = steps[:MAX_STEPS]
...
return RagAnswer(steps=steps, citations=citations, stripped=stripped, refused=not citations)- 末尾没有引用的步骤删掉。模型输出被
max_tokens截断时,最后一行往往是半句话、没有引用。步骤以引用为锚,没锚的尾巴不展示。 - 最多 8 步。界面和接口契约都是按 8 步设计的。
- 一条合法引用都没有,整体按拒答处理。第 4 篇讲过,这是证据门之后的第二道防线。
那中间那个被剥掉引用的第 2 步呢?它会保留,但不再带任何编号。在界面上,有编号的步骤可以点开核对原文,没编号的步骤就是一句过渡说明,工程师一眼能看出哪些话是有出处的、哪些不是。
最近一次 80 道题的评测里,被剥离的非法引用数是 0。也就是说,在这套题、这个模型上,模型一次都没有编造过引用。引用校验在这里没有「干活」。但它不是为平常准备的,是为换了模型、换了语料、模型状态不好的那一天准备的。保险就是这样,没出事的时候看起来最多余。
四、多批次冲突:并列,不替人选
第 3 篇讲了批次路由:知道批次就只查那个批次。如果不知道呢?比如宿主系统没给批次,工程师在追问时选了「不确定(并列展示)」。
这时检索结果里可能同时有 B22 和 B23 的资料。系统的处理很保守:
def detect_conflict(items: list[ScoredChunk], *, top_n: int = 3) -> dict | None:
    """同一型号命中多个批次的资料 → 并列展示,系统不替工程师选择(纪律 7)。"""
    head = items[:top_n]
    batches: dict[str, list[str]] = {}
    for item in head:
        if item.batch:
            batches.setdefault(item.batch, []).append(item.evidence_id)
    if len(batches) < 2:
        return None
...排名前 3 的证据里出现了两个以上批次,就在回答前先推一条冲突提示:
检索到多个批次/版本的资料,方法或参数可能不同。系统不替你选择,请先确认本机出厂批次,再按对应条目执行;现场无法确认时请联系厂家。
同时,提示词的第 4 条要求模型:不同资料给出的数值或做法不一致时,并列列出并分别标注出处,说明各自适用条件,不要替工程师选一个,也不要因此拒答。
最后呈现给工程师的是两组参数、两个出处,外加一句「请先确认批次」。系统不替他做这个判断,因为它没有做这个判断的依据。铭牌在工程师面前,不在系统面前。
五、推理模型的两个坑
现在很多大模型都带「思考过程」,接口返回里除了 content,还有一个 reasoning_content。它给这个项目带来了两个坑,都记在 LLM 客户端的注释里。
第一,思考过程绝不能进答案。 推理内容里完全可能出现「证据 M23002 提到……不过也可能是 M23005……」这样的自言自语。如果它混进了答案,引用校验会把里面的编号当成引用来核对,整个回答就乱套了。客户端在流式解析时直接把 reasoning_content 丢掉,只记一个字符数用于观测开销。
第二,思考会吃掉预算。 推理 token 也算在 max_tokens 里。代码注释里记着一次实测:max_tokens 设成 16 时,模型把预算全花在思考上,返回的 content 是空的。客户端会区分「真的没内容」和「被推理吃光了」,后者抛一个专门的错误,提示加大预算。
在问答管线里,遇到这个错误会加倍预算重试一次:
try:
    result = llm.complete(messages_list, max_tokens=budget, temperature=0.0)
except LlmError as exc:
    if exc.code != "LLM_EMPTY_CONTENT":
        raise
    logger.warning("empty content, retry with larger budget: %d -> %d", budget, budget * 2)
result = llm.complete(messages_list, max_tokens=budget * 2, temperature=0.0)带证据回答的默认预算是 2600 token,按「最多 8 步、每步带引用」估的,太小会把最后一步截断。配置层还兜了一个底:max_tokens 不允许低于 800。
六、小结
| 关卡 | 位置 | 拦什么 | 成本 |
|---|---|---|---|
| 安全词表 | 最前面 | 高风险操作类问题 | 1~2 毫秒,不调模型 |
| 提示词规则 | 生成时 | 证据外知识、改写过的安全问题 | 靠模型自觉 |
| 引用校验 | 生成后 | 编造的、本轮没见过的编号 | 一个纯函数 |
| 冲突提示 | 生成前 | 多批次资料被混成一个答案 | 一次遍历 |
第 4 篇和这一篇合起来,就是这个系统「不胡说」的全部机制:证据门管「能不能说」,安全红线管「该不该说」,引用校验管「说的有没有出处」。
答案生成好了,下一篇讲它怎么一帧一帧送到工程师面前,以及那个嵌在客户老系统里、一行代码都不用改的浮层。