
售后知识助手(八):上线之后,让它越用越准
老陈常说一句话:「知识库不是建出来的,是养出来的。」
他的笔记本记了二十年,每次遇到手册上没写的情况,修好之后就记一笔。新批次出来了,记一笔;某个型号的某个部件特别容易坏,记一笔。手册是厂家写的,笔记本是现场长出来的。
一个上线第一天准确率很高、第三百天还是那个样子的知识助手,其实是在退化:新批次的设备出来了,新的故障模式出现了,它都不知道。这一篇讲系统上线之后的事,怎么让它越用越准。
你在这里
全景图底部右侧那条:拒答、缺口与问答日志进后台运营
一、问答日志:每一轮都能复盘
工程师问的每一个问题,后台都能看到完整的处理链路:
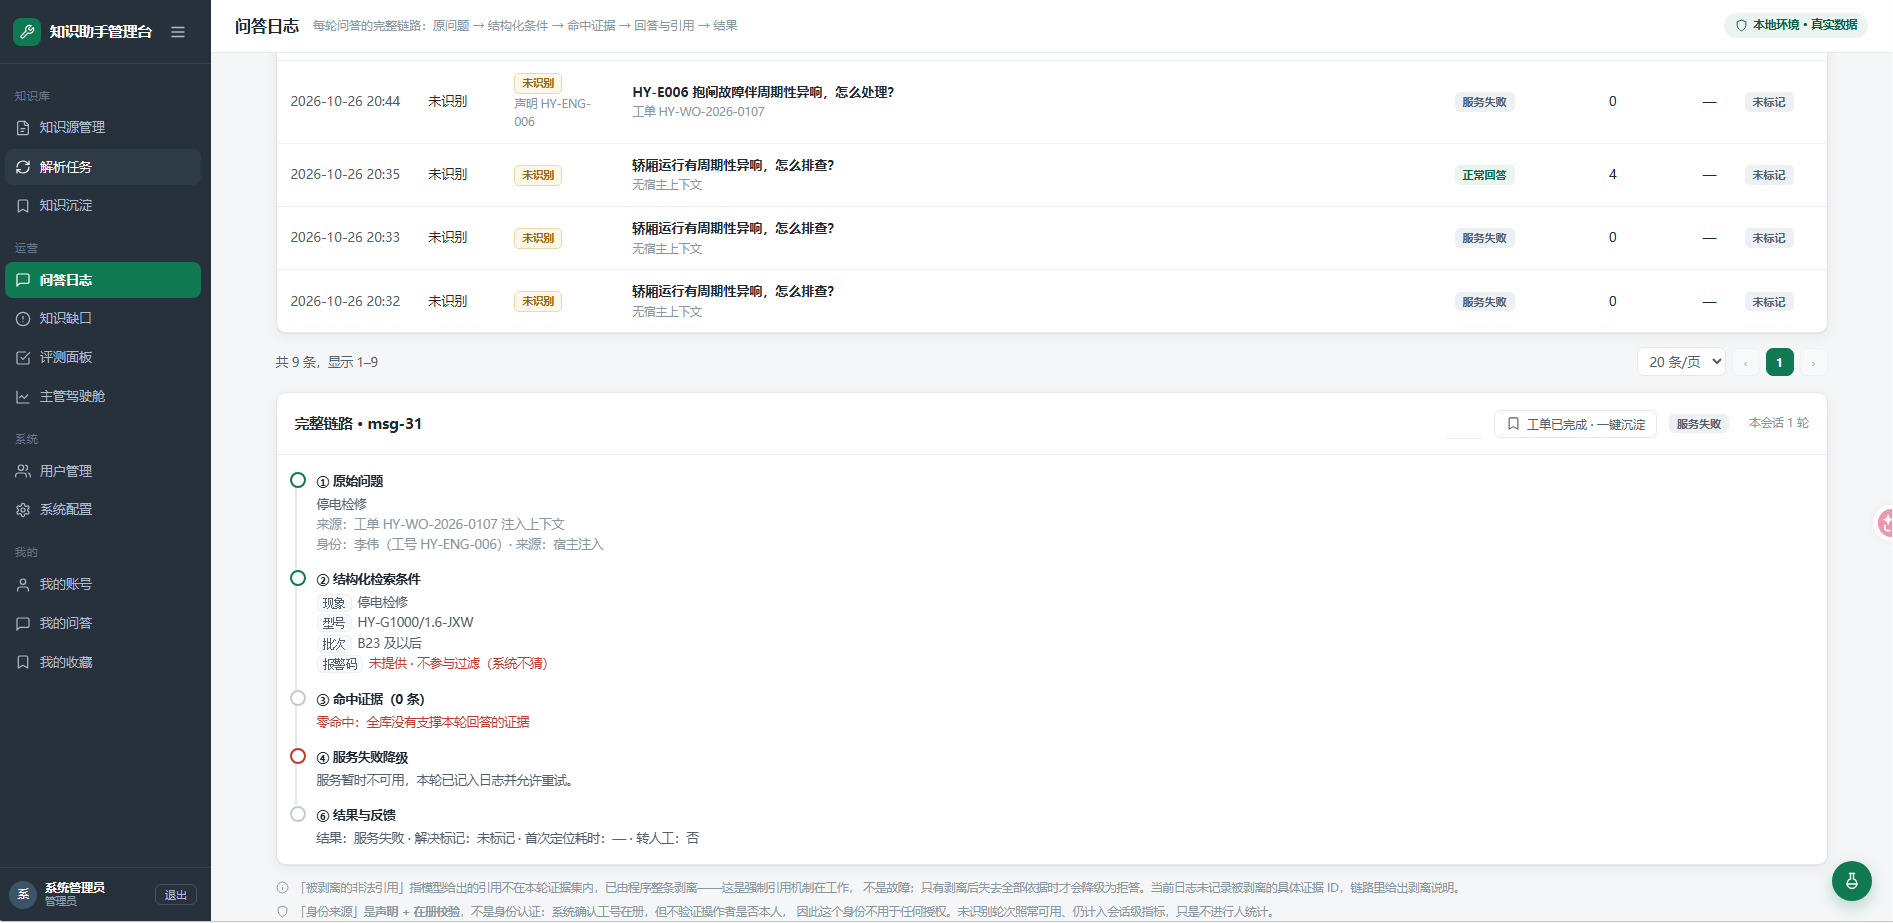
① 原始问题、来自哪张工单、谁问的 → ② 结构化检索条件(现象、型号、批次,以及哪些条件「未提供 · 不参与过滤,系统不猜」)→ ③ 命中了哪些证据 → ④ 回答和引用,或者拒答、降级的原因 → ⑤ 工程师的反馈。
截图里这一轮恰好是个失败的例子:命中证据 0 条,服务失败降级。日志不会把失败藏起来,失败的轮次和成功的轮次一样完整地摆在那里。
第 3 篇提到,每条证据都带着「来自向量、来自关键词、还是两路都有」的标记。调参的时候,问答日志就是第一手材料。
二、知识缺口:拒答不是终点
第 4 篇讲了证据门怎么拒答。拒答之后,这个问题去哪了?
它会进入后台的「知识缺口清单」。清单是从问答日志里聚合出来的:找出所有被证据门拒答的轮次,按问题文本聚合,同一个问题问了几次、最早什么时候、最近什么时候、涉及哪个型号,一目了然。
「同一个问题」怎么判断?工程师的问法五花八门,全角半角、标点、空格都不统一。聚合前先做一次归一化:
def _symptom_key(text: str) -> str:
    """症状归一化:全角转半角、转小写、去空白与标点,用于把同义提问聚合到同一缺口。"""
    raw = unicodedata.normalize("NFKC", (text or "")).strip().lower()
return re.sub(r"[\s!-/:-@\[-`{-~,。、;:?!“”‘’()《》【】…—·]+", "", raw)[:200]这只能把「写法不同的同一句话」归到一起,「意思相同的不同说法」还是会分成两条。语义聚合可以做,但我觉得现阶段没必要:缺口清单是给人看的,主管扫一眼就能认出哪几条说的是一件事。
每个缺口有三种状态:待补(open)、已覆盖(covered)、忽略(ignored)。主管补了资料,标为已覆盖,写一句「已由某某文档覆盖」;问题本身不该由这个系统回答(比如问广告报价),标为忽略。这几个字段是人维护的,后台每次从问答日志重新聚合时,只更新计数和时间,不覆盖人工填的状态和备注。
缺口清单的意义在于,它把「补资料」这件事从「凭感觉」变成了「照单办」。哪个问题被问得最多,就先补哪个。
三、知识沉淀:两根进水管,一道闸门
缺口清单解决的是「厂家资料里没有」的问题。还有一类知识,任何资料里都没有:老陈笔记本上的那些,现场修出来的经验。
系统给这类知识留了两根「进水管」:
- 收藏:工程师觉得某次回答特别有用,点「收藏入库」,这一轮回答成为一条候选。
- 工单:一张工单处理完,管理员在问答日志里点「工单已完成 · 一键沉淀」,这张工单里已解决的问答成为一条候选。
注意用词:候选。两根进水管都只产出待确认的候选,绝不直接入库。管理员在「知识沉淀」页面审核,可以修改正文和出处,确认之后才生成一条正式的证据单元,编号是工单类的 T 开头,从此和手册切片一样参与检索、可以被引用。驳回也会留痕,不删除历史。
为什么不能自动入库?设想一下:系统回答了一个问题,工程师觉得不错点了收藏,这个回答自动变成了证据。下次有人问类似的问题,系统检索到了这条「证据」,引用它作答。如果最初那个回答本身有错呢?错误的答案会变成证据,再被自己引用,形成一个自我证明的闭环。引用校验在这里完全失效,因为这个编号确实存在、确实是本轮检索到的。
所以这道人工闸门不能省。它保证了知识库里的每一条证据,最终都有一个人为它的正确性负过责。
两个实现细节:沉淀进来的正文会把原回答里的引用标记([M37004] 这类)去掉,入库的知识不应该带着内部编号;确认时会尝试向量化,向量服务失败也不阻断入库,这条证据先只能被 BM25 检索到,失败状态会返回给管理员。
四、驾驶舱:用起来没有,答得准不准
售后主管要向上汇报,最关心三件事:用起来没有、答得准不准、谁还没在用。
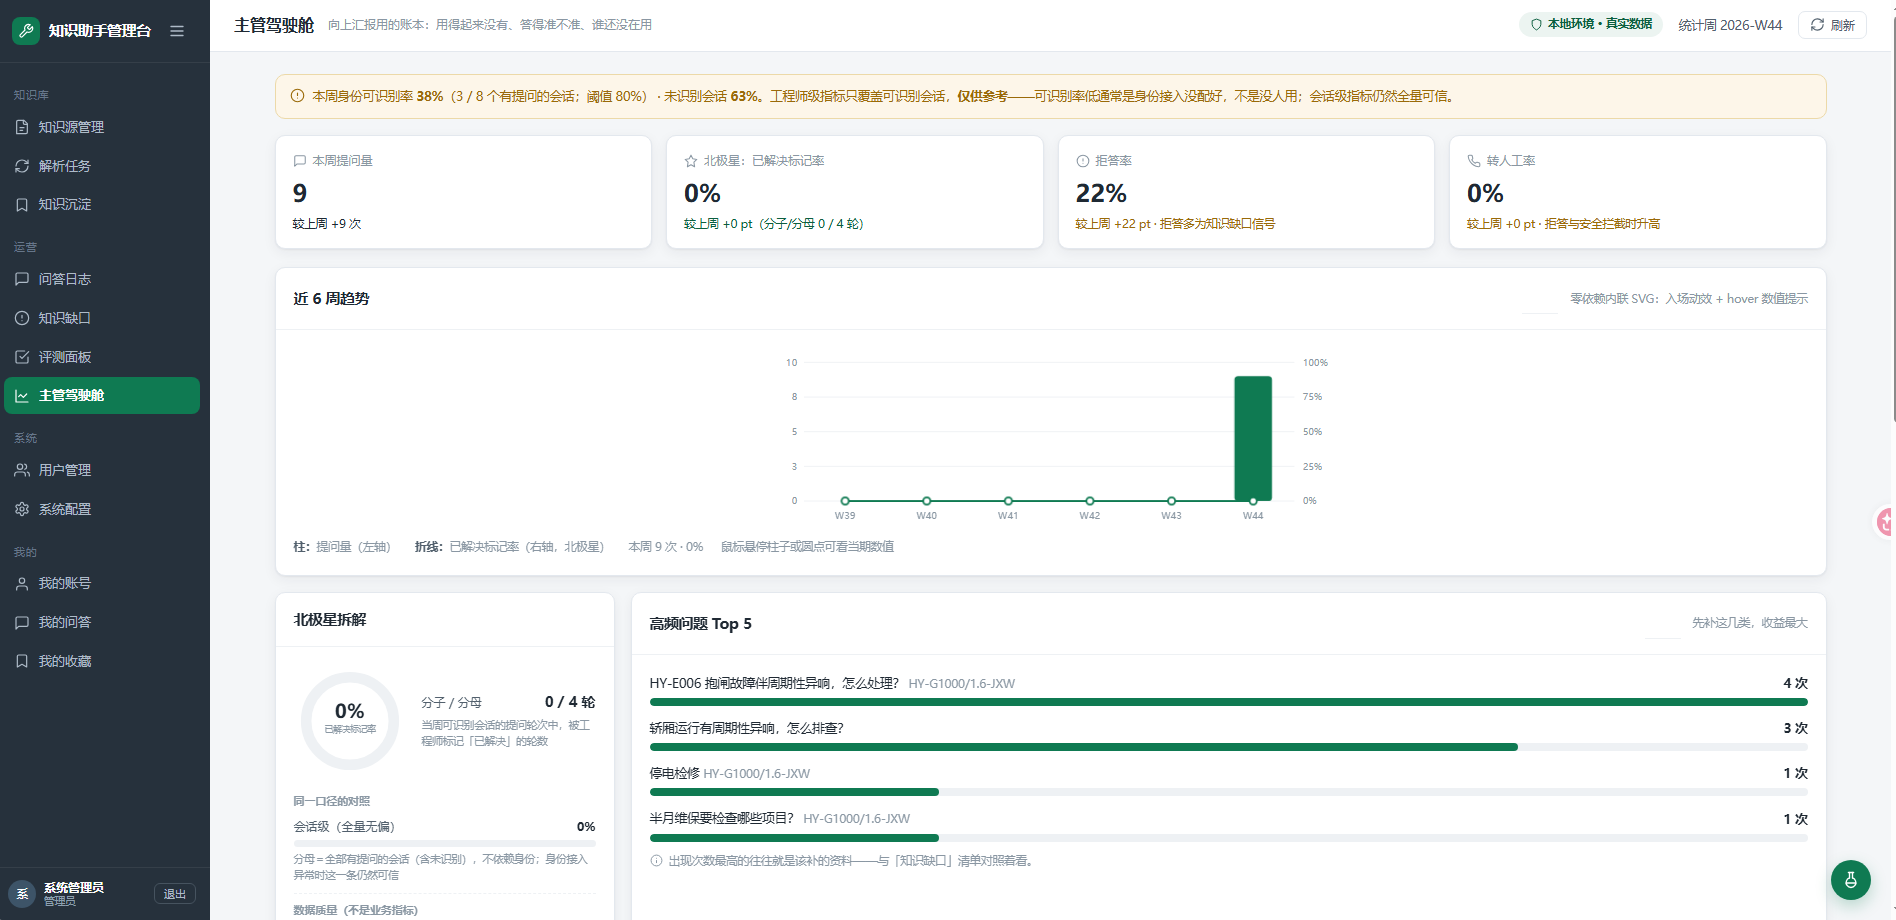
北极星:已解决标记率
只选一个指标衡量这个系统有没有价值,我选的是「已解决标记率」:工程师在回答下面点了「已解决」的轮次占比。
它比「提问量」诚实。提问量高,可能是系统好用,也可能是系统总答不对、工程师换着法问了五遍。「已解决」是工程师在现场亲手点的,这个信号很难被刷。
两条轨道,同时看
这里有一个口径上的麻烦:要知道「谁在用、谁没在用」,必须知道每个问题是谁问的。但第 6 篇讲过,身份是宿主系统声明的,宿主没传、或者传了一个不在册的工号,这个会话就是「未识别」。
驾驶舱的做法是两条轨道:
- 会话级指标:包含所有会话,不管识别没识别。回答「整体用得怎么样」。
- 工程师级指标:只覆盖识别出身份的会话。回答「每个人用得怎么样」。
截图顶部那条黄色提示就是这么来的:本周身份可识别率只有 38%,低于 80% 的阈值,所以工程师级指标「仅供参考」,旁边还有一句解释,可识别率低通常是身份接入没配好,不是没人用。没有这句话,主管看到北极星指标很低,第一反应可能是「工程师们不爱用」,而真实原因可能只是宿主系统的工号字段没传过来。
另外两条口径规则,写在统计接口的注释里,所有统计端点统一执行:管理员在后台自测的会话不进任何指标;没有数据的时候,比例返回 0、条数返回 0,不编造、不用估算值填充。
高频问题 Top 5
驾驶舱右下角是本周被问得最多的 5 个问题,旁边一行小字:「出现次数最高的往往就是该补的资料,与『知识缺口』清单对照着看」。驾驶舱和缺口清单是同一件事的两面。
五、账号即工号
后台账号的设计很朴素:账号就是工号,全平台唯一、不可修改、不可复用。两级角色,管理员和普通用户,不做复杂的权限体系。
有一个特殊的哨兵账号 __unidentified__,不能登录,只用来在统计时归属那些未识别的会话。这样「没识别出身份的提问」在报表里有一个明确的位置,而不是悄悄消失。
六、公开演示:演示码不是安全边界
这个项目可以开一个公开演示环境,让感兴趣的人直接试。演示环境要解决的核心问题是成本:大模型是按 token 计费的,不能让人无限地问。
配额分四层,按顺序检查:
| 维度 | 默认额度 |
|---|---|
| 单次会话 | 6 轮 |
| 单个演示码每天 | 60 轮(公开码跳过这一层) |
| 单个 IP 每天 | 20 轮 |
| 全局每天 | 200 轮 |
几个细节:计数发生在调用大模型之前,超限直接返回一帧「额度已用完」,不写日志、不调模型;四个维度在同一个事务里判定,任何一个超限整体回滚,不会出现「全局额度扣了、IP 额度却不够」的错账;按 IP 计数时,默认不信任 X-Forwarded-For 请求头,因为它可以被随意伪造,只有确认部署在可信的反向代理后面才打开。
演示码的定位,代码注释里写得很清楚:
演示码是分流与归因工具,不是安全边界:公开码写在官网链接里,等于公开;成本闸是配额。
不把演示码当安全措施,也就不会因为「有演示码」而放松对配额的设计。
部署到公网前还有一件事一定要做:把 JWT_SECRET 换掉。.env.example 里的默认值是 dev-only-change-me-please-32bytes!,名字已经说明了一切。
七、写在系列最后
八篇写下来,这个项目真正想说的其实只有一句话:一个能上线的 RAG,难的不是让它答对,而是让它在答不对的时候不乱答。
回头看,每一篇都在讲某种「不」:
- 第 1 篇:能不加的组件不加
- 第 2 篇:不知道的页码不编
- 第 3 篇:没有测出收益的重排不开
- 第 4 篇:证据不够格不答
- 第 5 篇:安全话题不过模型,本轮没见过的编号不认
- 第 6 篇:没校验过的步骤不推
- 第 7 篇:测不出来的指标不填
- 第 8 篇:没经过人确认的经验不入库
这些「不」加起来,才是工程师敢用它的原因。
这个项目还有不少想做、还没做的事,有兴趣的话欢迎一起:
- 安全意图分类器,补上子串词表挡不住的改写(第 5 篇)
- 按步骤流式推送,每校验完一步就推一步(第 6 篇)
- 人工基线和批次混淆率,补上评测面板上那两个空格(第 7 篇)
- 从真实问答日志里挑评测题,替换掉我自己出的题(第 7 篇)
代码都在 GitHub 上,Apache-2.0 协议,配好 .env 之后 Docker Compose 就能跑起来,自带 30 份演示语料。跑起来之后,先问它一个资料里没有的问题,看它怎么说「我不知道」。