
售后知识助手(四):证据门,宁可拒答不硬答
电梯上有个装置叫超载保护。轿厢里的重量超过额定载重,蜂鸣器一响,门不关,车不走,非得有人下去才行。没有人会觉得这是电梯「不够智能」。它不往前开,是因为往前开的后果承担不起。
证据门就是知识助手的超载保护。
李伟问:「2025 年新款控制器的固件升级步骤是什么?」演示语料里没有任何关于固件升级的资料。一个普通的 RAG 会怎么做?检索照样会返回一堆切片,里面有断电、挂牌、控制柜检查之类的内容,大模型照样能拼出一份「先断电、再连接调试口、上传固件、重启验证」的步骤,每一步都像那么回事。
这个系统的回答是:
未查到可靠依据,本次不作答。 现有手册、FAQ 与历史工单中没有与该问题直接相关的资料。为避免给出无法核验的操作建议,本次不生成回答。本次查询已记入后台「知识缺口清单」,售后主管会据此补充资料。
评测里这道题从提问到拒答用时 0.25 秒,大模型一次都没调。
你在这里
浮层提问 → 安全红线 → 结构化条件 → 混合检索 → 证据门 → 生成与引用校验 → SSE 返回
一、为什么不能交给提示词
最省事的做法是在提示词里写一句:「如果证据不足以回答,请回复不知道。」这个项目的系统提示词里确实也有这一条。但只靠它,有三个问题:
- 它是请求,不是保证。大模型被训练成乐于助人的样子,证据「沾点边」的时候,它倾向于凑一个答案出来。凑出来的答案往往格式工整、语气笃定,比一眼就能看出的胡说更难发现。
- 它没法审计。模型拒答了,你不知道它为什么拒;模型没拒,你也不知道它差一点就该拒。出了事故复盘,日志里只有一段生成的文本。
- 它很贵。为了让模型判断「该不该答」,你得先把十几条证据塞进提示词、等它生成,一次几秒钟、几千个 token,最后换来一句「我不知道」。
证据门把这件事挪到了模型前面,用代码判断:几个数字、几个阈值,判断依据全在日志里,拒答不花一个 token。
二、三条硬指标
整个证据门模块不到 100 行,核心判断是这样的:
hits = len(items)
dense_scores = [item.dense_score for item in items if item.dense_score is not None]
top_score = max(dense_scores) if dense_scores else None

# 覆盖度:查询词(去重、去单字噪声)在命中证据正文里是否出现
terms = [token for token in dict.fromkeys(query_tokens) if len(token) >= 2]
if terms:
    haystack = "\n".join(item.content for item in items)
    matched = [term for term in terms if term in haystack]
    coverage = len(matched) / len(terms)
    missing = _distinct_terms([term for term in terms if term not in matched])
else:
    coverage = 1.0 if hits else 0.0
    missing = []

if hits < min_hits:
    return GateResult(False, "gap", hits, top_score, coverage, missing)
if top_score is not None and top_score < min_score:
    return GateResult(False, "gap", hits, top_score, coverage, missing)
if coverage < min_coverage:
    return GateResult(False, "gap", hits, top_score, coverage, missing)
return GateResult(True, None, hits, top_score, coverage, missing)modules/evidence/gate.py#L51-L90
| 指标 | 含义 | 默认阈值 |
|---|---|---|
hits | 证据集里有几条 | ≥ 1 |
top_score | 证据里最高的向量相似度 | ≥ 0.35 |
coverage | 问题里的关键词,有多大比例在证据正文里出现过 | ≥ 0.5 |
三条任一不满足就是 gap。前两条是常见做法,第三条是我加的,后来发现它才是主力。
顺带说一个模块设计上的细节。证据门需要读检索结果的 content 和 dense_score,但按架构纪律,modules/evidence 不能 import modules/retrieval。所以它用 Protocol 声明自己只关心这两个字段,检索结果对象天然满足,两个模块之间没有任何 import:
class GateItem(Protocol):
    content: str
dense_score: float | None三、实测:真正干活的是覆盖度
评测集里有 9 道「资料里没有答案」的题。下面是它们在最近一次评测(2026-10-23,80 道题)里的真实数据:
| 问题 | 最高相似度 | 覆盖度 | 在哪一关停下 |
|---|---|---|---|
| 量子计算机的退相干时间怎么测量? | 0.45 | 0.29 | 证据门 |
| 电梯广告投放的报价是多少? | 0.56 | 0.40 | 证据门 |
| 2025 年新款控制器的固件升级步骤是什么? | 0.57 | 0.43 | 证据门 |
| 机房空调选哪个品牌好? | 0.51 | 0.50 | 无引用,不作答 |
| 电梯物联网平台的 API 接口怎么对接? | 0.62 | 0.50 | 无引用,不作答 |
| 电梯年度定期检验要交多少检验费? | 0.69 | 0.71 | 无引用,不作答 |
| 钢丝绳的报废标准是什么,直径磨损多少必须更换? | 0.52 | 0.67 | 只答有依据的部分,明示缺口 |
| HY-G2000 型号的额定载重量是多少? | 0.59 | 0.86 | 只答有依据的部分,明示缺口 |
| 使用登记证上的使用单位变更怎么办理? | 0.60 | 1.00 | 只答有依据的部分,明示缺口 |
作为对照,62 道资料里有答案的题:最高相似度最低 0.59,中位数 0.75;覆盖度最低 0.50,中位数 1.00。
这张表里有两个结论。
第一,向量相似度当不了拒答依据。 拿量子计算机的问题去查电梯手册,最高相似度还有 0.45,远高于 0.35 的阈值。9 道应拒答题的相似度落在 0.45 到 0.69 之间,而有答案的题最低才 0.59,两个区间重叠在一起。
你可能会想:把阈值提到 0.55 呢?在这 80 道题上确实能多拦两道,也不误伤。但有答案的题最低是 0.59,余量只有 0.04。换一批问题、换一个 Embedding 模型、多导入一批资料,这条线会落在哪里,谁也说不准。用一个只差 0.04 的阈值守门,等于没有门。所以 0.35 只是个兜底,防的是检索彻底跑偏的情况。
第二,三道被证据门拦下的题,全是覆盖度拦的。 原因很朴素:「量子」「退相干」「广告」「报价」「固件」这些词,在电梯售后资料里根本不出现。向量会把「退相干时间怎么测量」和「制动器间隙怎么测量」拉得很近,因为都在「测量什么」;但字面检查不吃这一套,没有就是没有。
至于 hits ≥ 1 这一条,在有语料的库里几乎永远满足。上一篇结尾说过,检索永远会返回点什么。它只在库是空的、或者按型号批次过滤后真的一条都没有时才起作用。
粗糙但稳的信号,往往比精致但飘的信号好用
「关键词有没有在证据里出现」听上去很土,不懂同义词,也不懂语序。但它的失败方式是可预期的:要么误拦(问法太口语),要么漏放(关键词都在但说的不是一回事)。前者可以靠调词表修,后者交给后面的防线。相似度分数的失败方式则是不可预期的,你不知道它下一次会在哪个数上翻车。
四、覆盖度的两个坑
口语会被误拦
评测集里有一道题模仿工程师的真实问法:「之前那台梯门关到一半又弹开,是怎么修好的?」历史工单台账里有这个案例,工单号 HY-WO-2026-0021。可最早这道题被证据门拦下了,覆盖度 0.43。
原因是分词后的查询词里有「之前」「那台」「修好」,这些是工程师口述的习惯,工单正文里不会这么写。它们拉低了覆盖度,却跟问题的事实毫无关系。
修法是给覆盖度计算单独加一张停用词表,专收这类口语化的时间词和指代词:
_COVERAGE_STOPWORDS = frozenset({
    # 疑问/请求类
    "怎么", "如何", "多少", "什么", "为什么", "哪种", "哪些", "是否", "可以", "需要", "请问",
    # 口语化时间与指代:工程师口述里常见,但不是证据里的事实词
    "之前", "上次", "后来", "最后", "那台", "这台", "当时", "记得", "案例", "修好",
})现在这道题的覆盖度是 0.75,正常作答,证据集里找到了那张工单。
注意这张表放在 app 层,而不是 modules/evidence 里。「那台」「修好」是售后行业的说话习惯,换到医疗器械售后,口语词就是另一批了。机制归 modules,词汇归 app,这条纪律在一张停用词表上也要守住。
缺失词要能看懂
证据门不通过时,会把「哪些词没在证据里找到」一起返回,记进知识缺口清单,也通过 SSE 推给前端。售后主管看到缺口清单,应该一眼知道该补什么资料。
jieba 的搜索引擎模式会产出互相重叠的词,比如「计算机」会同时切出「计算」「算机」「计算机」。直接把这些都列出来,缺口清单就成了一堆碎片。所以缺失词展示前会去掉被更长的词包含的短词:
def _distinct_terms(terms: list[str]) -> list[str]:
    """去掉被更长词包含的短词(jieba 搜索模式会产出"计算/算机/计算机"这类重叠)。"""
    ordered = sorted(set(terms), key=len, reverse=True)
    return [
        term
        for term in ordered
        if not any(term != other and term in other for other in ordered)
]只留「计算机」,不留「算机」。
五、证据门不是最后一道门
回到那张表。有 6 道题通过了证据门,最后却没有编造答案,靠的是后面两道防线。
第二道:无引用,不作答。 提示词要求模型每一步都标注证据编号,证据确实无关时只回一句「现有资料不足以回答这个问题」。模型的输出回来之后,代码逐行解析、逐个核对引用编号是否属于本轮证据集。最后一条判断非常简单:
return RagAnswer(steps=steps, citations=citations, stripped=stripped, refused=not citations)refused=not citations,一条合法引用都没有,就按拒答处理。模型说了「资料不足」,没有引用,拒答;模型硬凑了几步但引用全是编的,编造的引用被剥离之后同样没有引用,还是拒答。两种情况在代码里是同一个判断,不需要去理解模型到底说了什么。空调品牌、物联网接口、检验费这三道题,都是在这里停下的。
第三道:只答有依据的部分。 剩下三道题,资料里有一部分相关内容。比如钢丝绳报废标准:手册里有钢丝绳的检查方法,但没有「直径磨损多少必须更换」的具体数值。这时模型回答了检查方法,每一步都带引用,同时明确说了资料里没有给出报废的磨损限值。
这三道算不算通过,我犹豫过。严格说,题目标的是「应拒答」,系统没有拒答。但它没有编造任何数值,给出的每一步都能核对到原文,缺的部分也说清楚了。对现场工程师来说,这比一句干巴巴的「不知道」更有用。所以评测脚本把它单独记为「明示缺口」,不算失败,但在报告里单列一行,不和真正的拒答混在一起。识别方式也写在代码里:回答中出现「未给出」「未覆盖」「无法确认」这类措辞才算明示,判定口径谁都能看到。
为什么不把三道防线合成一道
每一道的成本和失败方式都不一样。证据门最便宜,0.2 秒、不调模型,但只能拦「明显无关」的问题;引用校验要等模型生成完,几秒钟、几千 token,但能拦住「沾边但其实答不了」的问题;明示缺口靠的是模型的表达,最贵,也最灵活。便宜的放前面,贵的放后面,每一道只处理前一道漏下来的。
六、拒答之后
拒答不是终点。证据门拦下的每一个问题都会落进问答日志,后台的「知识缺口清单」从这些拒答记录里聚合出来:哪些问题被问了、涉及哪个型号、问了几次。售后主管照着清单补资料,补完的问题下次就能答了。
工程师这一侧,拒答之后浮层上有一个「转人工」按钮。转过去的时候,当前工单号、设备型号与批次、对话记录、已经引用过的依据都会一起带给接手的值班工程师,客户不用把问题再讲一遍:
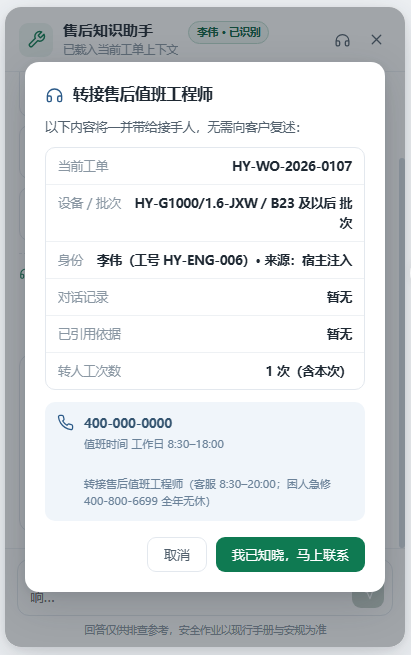
一个会说「我不知道」的系统,还得把「不知道」之后的路铺好。否则它只是把锅甩回给了工程师。知识缺口怎么闭环、沉淀下来的经验怎么经人工确认再入库,是第 8 篇的内容。
七、小结
证据门相关的配置:
| 参数 | 默认值 | 说明 |
|---|---|---|
EVIDENCE_MIN_HITS | 1 | 几乎总能满足,兜底用 |
RETRIEVAL_MIN_SCORE | 0.35 | 向量相似度下限,只防检索彻底跑偏 |
EVIDENCE_MIN_COVERAGE | 0.5 | 主力指标;后台可在线调整,保存后下一次问答生效 |
如果只能从这篇带走一句话:判断「能不能答」,不要交给负责「回答」的那个模型。 让它回答之前,先用一段便宜、可解释、可测试的代码把门;让它回答之后,再用一段同样便宜的代码核对它引用的东西是不是真的存在。
模型生成时的提示词怎么写、引用编号怎么设计、编造的引用怎么剥离、安全话题为什么连模型都不调,留给第 5 篇。